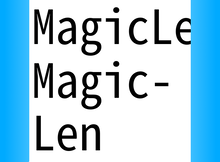
如何使 HTML 網頁在斷字時斷在我們想要的位置上?
在使用 HTML 編寫網頁的時候,如果是使用英文撰寫,一旦單詞很長,當能夠顯示單詞的寬度不夠時,就會衍生出斷字的問題。要如何讓 HTML 把字斷在我們想要的位置上呢?


MagicLen · https://magiclen.org
本站也提供简体中文版。切换到简体中文版
分類
程式設計的教學與經驗分享,涵蓋 Rust、Java、JavaScript、Go、C/C++ 等程式語言的入門教學、範例程式與實務技巧,以及演算法、App 開發與開發工具的用法。
共 635 篇文章
在使用 HTML 編寫網頁的時候,如果是使用英文撰寫,一旦單詞很長,當能夠顯示單詞的寬度不夠時,就會衍生出斷字的問題。要如何讓 HTML 把字斷在我們想要的位置上呢?
在開發程式的時候我們時常會需要判斷某個字串的開頭或結尾是否符合某個字串,例如判斷網址是否以「http」或是「https」開頭時,或是判斷檔案名稱是否以「.jpg」或是「.png」結尾時。然而在上述提到的例子中,通訊協定或是檔案副檔名都是可忽略大小寫的,Rust 程式語言雖然有提供 eq_ignore_ascii_case 方法,卻沒有提供 starts_with_ignore_ascii_case...
在 Rust 程式語言中,可以透過筆者開發的「Boyer-Moore-MagicLen」套件,用「BMByte」或「BMCharacter」結構體在位元組資料、UTF-8 字串或字元序列中進行快速的搜尋。這篇文章會說明它的用法,包含全文搜尋、一般搜尋以及由右往左的搜尋。
CIDR(Classless Inter-Domain Routing, 無類別域間路由)是用來區分 IP 網段十分好用的方法,之所以會被稱為「無類別」,是相對於過去將 IPv4 分為 Class A~E 這五類的方式,CIDR 則是直接以 IP 位址的前綴來分類網路,要多長有多長、要多短有多短,十分自由。Rust 程式語言的標準函式庫雖然有內建 IPv4 和 IPv6 的結構體,但充其量也只能拿...

基數排序(Radix Sort)演算法是可以利用多個鍵值來排序資料的演算法。排序還需要多個鍵值?有時候當然會需要啦!像是要排序檔案時,可以先依照檔案名稱排序後,再依照檔案大小來排,如此一來,整體上來看這些檔案,會是以檔案大小來排序,而相同檔案大小的檔案則是會依照檔案名稱來排序。基數排序法可以將整數的各個位數當作是鍵值,來進行線性時間的排序,比起會依照 k(要排序的資料可能的值的數量)愈大而愈吃空間...
桶排序(Bucket Sort)演算法是先將大量資料分類成少量資料後,再進行排序的演算法。可以透過簡單的運算式來完成資料的分類,在最好的情況之下,資料可以被完全打散,此時的時間複雜度就會是一個線性時間。

這裡所稱的搜尋(Search),是指在一個已排序好或是尚未排序好的集合中,將指定元素的鍵值(key)或是索引值(index)搜尋出來,或者是給定某個條件,在集合中搜索出符合該條件的資料。在集合內搜尋元素的方法當然不會只有一種,而不同方法搜尋資料的難易度、速度和其它特性自然也會有所不同。搜尋演算法(Search Algorithm)就是搜尋資料的方法,目前已知的方法有很多,在這篇文章中將會整理本站所...
暴力字串搜尋(Brute-force Substring Search)演算法是最基本的字串搜尋演算法。它可以按照原文中字元的順序,逐一與搜尋樣本(pattern)進行比對,判斷目前的搜尋位置是否就是搜尋樣本存在的位置。
插補搜尋(Interpolation Search)演算法又稱為內插搜尋演算法,是二元搜尋(Binary Search)演算法的變體。這套演算法可以在已排序好的序列中根據資料的預測線或近似線來進行高效率的搜尋,近似線愈精準,搜尋的效率就愈高。
指數搜尋(Exponential Search)演算法又稱為雙倍搜尋(Doubling Search)演算法或是蔓延搜尋(Galloping Search)演算法,是二元搜尋(Binary Search)演算法的變體。這套演算法可以在已排序好的序列中進行高效率的搜尋,要搜尋的元素在序列中愈前面的話,搜尋效能愈好。