

在这个章节将会介绍许多其它编程语言也都有的基础概念,包含变量、数据类型、函数、注解以及条件和循环的流程控制。
变量
我们其实已经会用变量了,这边再加强一下观念。在上一章节中,我们提到了使用 let 声明出来的变量是不可变的,如果要让变量可变,需要加上 mut 关键字。这样的设计习惯虽然和其它语言差异蛮大,但也是有它的优点在,如果变量预设被声明出来后就可以一直被改变的话,我们很容易就会不小心改掉某个重要变量的值而导致程序运行结果有误,通常发生这样的情况后,会需要不少的时间才能找出问题所在,然而 Rust 编程语言这样的设计习惯却能在撰写代码的阶段就已经大大地减少这个情况发生的可能性了。
但所谓的「不可变的变量」,究竟是指「变量本身保存的值」不会改变,还是「变量保存的值本身」不会改变呢?
来做一个小实验,程序如下:
fn main() {
    let s1 = String::new();
    let mut s2 = String::new();

    s1.push_str("s1");
    s2.push_str("s2");

    println!("{s1}");
    println!("{s2}");

    s1 = String::from("Hello");
    s2 = String::from("Hi");

    println!("{s1}");
    println!("{s2}");
}
注意程序第 5 行和第 11 行,我们分别对没有使用 mut 的 s1 变量的值和 s1 变量本身所保存的值进行修改的动作,程序编译的结果如下:
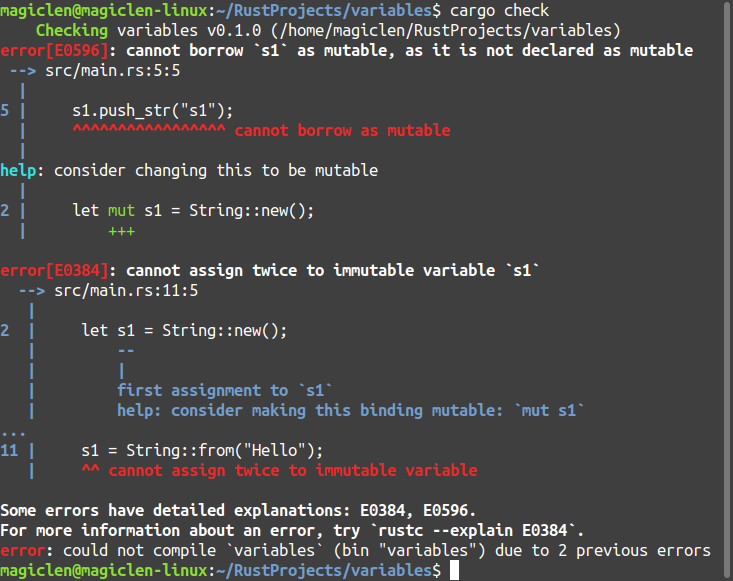
根据上图,我们可以看到程序第 5 行和第 11 行都是无法通过编译的!也就是说「不可变的变量」,「变量本身保存的值」不会改变,且「变量保存的值本身」也不会改变。若将 s1 变量加上 mut 关键字来声明,程序即可通过编译。
「不可变的变量」不就跟常数(constant)是一样吗?虽然它们看起来都是值不可以改变的名称,但还是有一些差异。在 Rust 编程语言中,提供了 const 关键字来声明常数,与用 let 声明变量不同的是,const 不允许加上 mut 关键字来让常数变成可变的,因为「可变的常数」就根本不是常数了嘛!再来就是 const 声明常数时,必须要明确地给出常数的类型,因为常数的值在 Rust 程序的编译阶段时,就需要确定下来了,换句话说,常数也无法保存程序运行阶段才能得到的数据。常数可以被声明在任何的 scope,包含全域的 scope,且名称习惯都使用大写字母,并使用底线区隔不同的单字。例如:
const MAX_POINTS: u32 = 100000;
常数存在的目的是要让代码更容易维护,利用常数来表示代码之后可能会更动的设置值是很常见的用法。上一章提到的变量「屏蔽」(shadowing),常数并没有这种特性,如果在同一个程序 scope 下,声明了相同名称的常数,程序就会编译错误。
有关于变量「屏蔽」,举个一般的例子:
fn main() {
    let x = 5;

    let x = x + 1;

    let x = x * 2;

    println!("The value of x is: {x}");
}
以上程序第 4 行和第 6 行,由于重复使用 x 这个名称声明变量,因此发生「屏蔽」。由于等号右边会比左边先运行,因此第 4 行等号右边的 x 变量为第 2 行声明的 x 变量,所以要进行 5 + 1 这个运算,并将结果 6 指派给第 4 行声明出来的 x 变量保存。同理,第 6 行等号右边的 x 变量为第 4 行声明的 x 变量,所以要进行 6 * 2 这个运算,并将结果 12 指派给第 6 行声明出来的 x 变量保存。所以最后程序会输出:
变量只需相同名称即可「屏蔽」,因为其实就是再声明出一个新的变量来用了,所以就算类型不同也可以。举例来说:
fn main() {
    let spaces = "   ";

    let spaces = spaces.len();
}
以上程序第 4 行,由于重复使用 spaces 这个名称声明变量,因此发生「屏蔽」。第 2 行声明出来的 spaces 变量类型为字符串(确切来说是 &str),第 4 行声明出来的 spaces 变量类型为整数数值(确切来说是 usize),两者类型并不一样,但程序是可以通过编译的。
那么「屏蔽」和 mut 关键字的差别在哪里呢?除了「屏蔽」实际上会声明出新的变量之外,它们不都是将相同名称的变量所保存的值进行改变吗?以结果来说是这样没错,但还是有用法上的差异。mut 关键字并不能改变变量的类型,如以下程序:
fn main() {
    let mut spaces = "   ";

    spaces = spaces.len();
}
这个程序将会编译失败,因为程序第 4 行,尝试将整数类型的值指派给字符串类型的 spaces 变量。
数据类型
Rust 是「静态类型」(Static Typing)的编程语言,在编译阶段就要完全决定好变量的类型,因此可以让 Rust 程序在编译阶段就知道要怎么样保存和处理该类型的数据。使用 let 关键字声明变量的时候,通常可以不用事先指定好该变量的类型,因为编译器会自动根据第一次指派给变量的值来推论变量的类型。举例来说:
fn main() {
    let a;
    let b = 1;

    a = 2;
}
以上程序,变量 a 在声明时并未指定类型,而且也没有指派任何值。然而编译器知道程序第 5 行会将 i32 类型的 2 指派给变量 a,因此自动推论变量 a 的类型是 i32。
在某些情况下,由于「泛型」的关系有多种类型的可能,因此需要事先定义好变量的类型。前面的章节制作的猜数字程序,第二次声明出来的 guess 变量就是一个需要事先明确定义好类型的例子。
let guess: i32 = guess.trim().parse().expect("Please type a number!");
纯量类型(Scalar Types)
只有一个值的类型称为「纯量类型」,Rust 编程语言中一共有四种基本的纯量类型,分别是整数(integer)、浮点数(floating-point)、布尔(boolean)、字符(character),底下将分别介绍这四种类型。
整数
没有小数字数的数值就是整数,Rust 编程语言对于整数数值类型,区分了有号整数(i)和无号整数(u),整数依照表示范围区分为 8 比特、16 比特、32 比特、64 比特和 128 比特。先前我们已经使用过了 i32 类型,用来表示 32 比特的有号整数,32 比特的有号整数可以表示 -231 ~ 231-1 的整数数值范围。如果是要使用 8 比特的有号整数,类型名称为 i8,依此类推。不同长度的有号整数的数值表示范围公式如下:
将 i32 的 i 改为 u,变成 u32,可用来表示 32 比特的无号整数,32 比特的无号整数可以表示 0 ~ 232-1 的整数数值范围。如果是要使用 8 比特的无号整数,类型名称为 u8,依此类推。不同长度的无号整数的数值表示范围公式如下:
此外,有号整数和无号整数分别还有 isize 和 usize 这两种类型能够使用,它们的长度会跟程序的运行环境有关。如果程序是在 32 比特的环境下运行(如 x86),则 isize 和 usize 都会使用 32 比特;如果程序是在 64 比特的环境下运行(如 x86_64),则 isize 和 usize 都会使用 64 比特。
直接在 Rust 代码中撰写整数数值的话,会直接当作 i32 类型来处理,如果预设使用 isize 的话会造成很多不确定的因素,如果预设使用 i64 则是会太占保存和运算资源。Rust 编程语言支持的整数写法有很多种,除了一般直接写数字的方式外,还允许加上底线 _ 来分割太多位数的整数。例如:
let x = 12_345;
如同其它大部份编程语言,Rust 的整数也支持 16 进制、8 进制、2 进制的表示方式。如下:
let h = 0xff;
let o = 0o377;
let b = 0b11111111;
此外,还有一种针对字符值转换成 u8 类型的写法。如下:
fn main() {
    let c0 = b'0';
    let cA = b'A';

    println!("0 = {c0}, A = {cA}");
}
运行结果为:
有号整数的类型有 i8、i16、i32、i64、i128 和 isize。无号整数的类型有 u8、u16、u32、u64、u128 和 usize。请参考以下程序:
fn main() {
    let a = 1i8; // i8
    let a: i8 = 1; // i8
    let a = 1 as i8; // i8
    let a = 1i16; // i16
    let a: i16 = 1; // i16
    let a = 1 as i16; // i16
    let a = 1; // i32
    // let a = 2147483648; // i32
    let a = 2147483648i64; // i64
    let a: i64 = 2147483648; // i64
    let a = 2147483648 as i64; // i64
    // let a = 9223372036854775808; // i32
    let a = 9223372036854775808i128; // i128
    let a: i128 = 9223372036854775808; // i128
    let a = 9223372036854775808 as i128; // i128

    let a = 1u8; // u8
    let a: u8 = 1; // u8
    let a = 1 as u8; // u8
    let a = b'1'; // u8
    let a = 1u16; // u16
    let a: u16 = 1; // u16
    let a = 1 as u16; // u16
    let a = 1u32; // u32
    let a: u32 = 1; // u32
    let a = 1 as u32; // u32
    let a = 1u64; // u64
    let a: u64 = 1; // u64
    let a = 1 as u64; // u64
    let a = 1u128; // u128
    let a: u128 = 1; // u128
    let a = 1 as u128; // u128
}
程序第 8 行,直接在代码写的整数数值会预设使用 i32 类型。程序第 9 行,2147483648 为 231,已经超过 i32 的数值表示范围,但 Rust 并不会自动使用 i64 来保存,如果这行没有被注解掉的话,编译器会知道写在代码的整数数值超出 i32 类型的表示范围(溢出),编译时就会出现错误消息。但是程序第 10 行,直接在代码中的整数数值后面接上 i64,这个数值就会被转型为 i64,解决了溢出问题。程序第 12 行,使用 as 关键字也可以解决溢出问题;程序第 13 行,9223372036854775808 为 263,已经超过 i32 和 i64 的数值表示范围,但 Rust 并不会自动使用 i128 来保存,如果这行没有被注解掉的话,编译器会知道写在代码的整数数值超出 i32 类型的表示范围(溢出),编译时就会出现错误消息。但是程序第 14 行,直接在代码中的整数数值后面接上 i128,这个数值就会被转型为 i128,解决了溢出问题。程序第 16 行,使用 as 关键字也可以解决溢出问题。
再整理一下,自行定义写在代码的整数数值类型的方式有三种:第一种是在整数数值之后直接接上整数类型名称(程序第 2、5、10、14、18、22、25、28、31 行),第二种是透过声明变量时定义变量的类型(程序第 3、6、11、15、19、23、26、29、32 行),第三种是使用 as 关键字来转型(程序第 4、7、12、16、20、24、27、30、33 行)。这里要注意一下,浮点数数值无法直接接上整数类型名称来转成整数类型。
浮点数
有小数字数的数值就是浮点数,Rust 编程语言对于浮点数数值类型,依照精准度,将长度区分为 32 比特的 f32(单精准浮点数)和 64 比特的 f64(双精准浮点数)。直接在 Rust 代码中撰写浮点数数值的话,会直接当作 f64 类型来处理,因为 f64 能够提供比 f32 还要更精确的数值,且运算速度在现代的 CPU 上是差不多的。
浮点数的类型有 f32、f64。请参考以下程序:
fn main() {
    let a = 1.0f32; // f32
    let a = 1f32; // f32
    let a: f32 = 1.0; // f32
    let a = 1.0 as f32; // f32
    let a = 1 as f32; // f32

    let a = 1f64;
    let a = 1.0; // f64
    let a = 1 as f64; // f64
}
程序第 9 行,直接在代码写的浮点数数值会预设使用 f64 类型。
自行定义写在代码的浮点数数值类型的方式有三种:第一种是在整数数值或浮点数数值之后直接接上浮点数类型名称(程序第 2、3、8 行),第二种是透过声明变量时定义变量的类型(程序第 4 行),第三种是使用 as 关键字来转型(程序第 5、6、10 行)。
浮点数和整数类型之间的转换一定要透过 as 关键字。以下的写法都会编译失败:
let a: i32 = 1.0;
let a: f64 = 1;
必须改用 as 关键字才可以编译成功:
let a = 1.0 as i32;
let a = 1 as f64;
如果是整数(或浮点数)变量要转换成其它整数(或浮点数)类型,方式和直接写在代码的数值一样:透过声明变量时定义变量的类型,或是使用 as 关键字来转型,而浮点数和整数类型之间的转换也是一定要透过 as 关键字。
布尔
和其它大多数的编程语言一样,Rust 的布尔类型也只有 true 和 false 两种值。布尔的类型名称为 bool。
字符
除了数值类型的类型之外,Rust 编程语言也支持 char 类型,可以用来处理字符。直接写在代码的字符必须使用单引号 ' 包起来,例如:
let c = 'C';
char 类型可以表示「Unicode Scalar」编码的值,也就是说,除了 ASCII 字符外,还可以表示中文、日文、韩文(CJK)的文字,也能表示表情符号。
复合类型(Compound Types)
复合类型可以将不同类型的值组合成一个类型。Rust 编程语言提供了两种基本的复合类型,分别是「元组(tuple)」和「数组(array)」。
元组
元组是一个将不同类型的值组合成一种类型的常用方式。在 Rust 编程语言中,可以利用逗号 , 在小括号 () 内分隔不同类型的值,就能将它们组合成元组。例如:
let t = (500, 6.4, 1, 'A'); // (i32, f64, i32, char)
以上程序,t 变量的类型就是一种元组类型,可以用 (i32, f64, i32, char) 来表示。换句话说,如果要在声明变量时明确定义变量的元组类型,可以将程序写成:
let t: (i32, f64, i32, char) = (500, 6.4, 1, 'A');
由于元组并未定义每个值所属字段的名称,但因其有顺序性,因此可以利用以下程序的语法,快速地将元组中的值指派给不同变量。
let t = (500, 6.4, 1, 'A');
let (a, b, c, d) = t; // a: i32, b: f64, c: i32, d: char
这里要注意的是,在 Rust 1.59 之前,只有在使用 let 关键字声明变量时,才可以直接将元组拆开。从 Rust 1.59 开始,就算没有使用 let 关键字,也可以直接将元组拆开并指派给已经声明的变量,所以以下的程序也能编译成功:
let t = (500, 6.4, 1, 'A');
let a;
let b;
let c;
let d;
(a, b, c, d) = t;
以上程序在 Rust 1.59 之前的版本需要改写成以下的样子,才能通过编译:
let t = (500, 6.4, 1, 'A');
let a;
let b;
let c;
let d;
a = t.0;
b = t.1;
c = t.2;
d = t.3;
元组的顺序是从索引 0 开始计算,可以利用 . 符号使用索引值指定要访问的元组字段。元组的索引值在程序编译阶段就要决定好,无法使用变量或是常数代替。
let mut t = (500, 6.4, 1, 'A');
t.0 = t.2;
以上程序,将元组 t 索引 2 的 1 存到索引 0 的位置,取代掉原本索引 0 的 500。
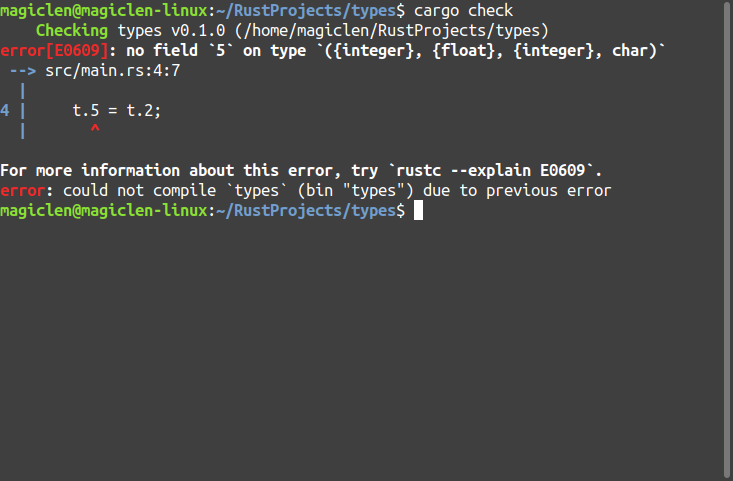
如果尝试使用超出元组范围的索引值,程序会编译失败。例如:
fn main() {
    let mut t = (500, 6.4, 1, 'A');
    t.5 = t.2;
}
编译结果如下图:
数组
数组的概念像是元组的简化版,元组可以保存多个不同型态的值,而数组只能保存多个相同型态的值(在数组中称为元素值(element))。Rust 编程语言的数组为固定长度,既不能增长也不能缩小,且长度在编译阶段时就要决定。利用逗号 , 在中括号 [] 内分隔相同类型的值,就能将它们组合成「数组」。例如:
let a = [2, 4, 6, 8, 10]; // [i32; 5]
以上程序,a 变量的类型就是一种数组类型,且长度为 5,可以用 [i32; 5] 来表示。换句话说,如果要在声明变量时明确定义变量的数组类型和数组长度,可以将程序写成:
let a: [i32; 5] = [2, 4, 6, 8, 10];
与元组相同,由于数组并未定义每个元素所属字段的名称,但因其有顺序性,因此可以利用以下程序的语法,快速地将数组中的元素指派给不同变量。
fn main() {
    let a = [2, 4, 6, 8, 10];
    let [v, w, x, y, z] = a;
}
同样地,在 Rust 1.59 之前,只有在使用 let 关键字声明变量时,才可以直接将数组拆开。从 Rust 1.59 开始,以下的程序也能编译成功:
let a = [2, 4, 6, 8, 10];
let v;
let w;
let x;
let y;
let z;
[v, w, x, y, z] = a;
以上程序在 Rust 1.59 之前的版本需要改写成以下的样子,才能通过编译:
let a = [2, 4, 6, 8, 10];
let v;
let w;
let x;
let y;
let z;
v = a[0];
w = a[1];
x = a[2];
y = a[3];
z = a[4];
数组的顺序是从索引 0 开始计算,可以利用中括号 [] 使用索引值指定要访问的数组字段。数组的索引值可以在程序运行阶段才决定。
let mut a = [1, 2, 3, 4];
a[0] = a[2];
以上程序,将数组 a 索引 2 的 3 存到索引 0 的位置,取代掉原本索引 0 的 1。
此外,也可以利用数组所提供的 get 方法来取得元素值。
let mut a = [1, 2, 3, 4];
let x = a.get(0);
使用 get 方法回传的数组元素值会被 Option 枚举包裹起来。Option 枚举在之后的章节会作介绍。
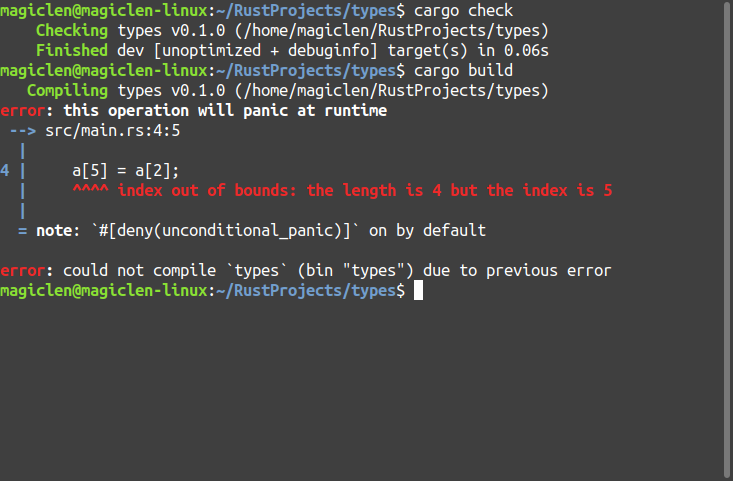
利用中括号 [] 使用超出数组长度范围的索引值尝试访问元素值,程序虽然可以通过 cargo check,但在预设情况下无法通过 cargo build。因为这是属于 Lint 方面的问题,这类问题硬是要进行编译是不会有错误的,甚至可被编译器给自动忽略或修正掉。如果是不能被编译器修正,在程序运行阶段才会出现错误但又显而易见的问题,这样的问题就会交给 Lint 来检查,在编译阶段阻止问题的发生。
例如:
fn main() {
    let mut a = [1, 2, 3, 4];

    a[5] = a[2];
}
编译结果如下图:
当然我们也可以强制让 Rust 编译器忽略 Lint 检查出来的错误,可以加上 --cap-lints=warn 参数给 Rust 编译器,使 Lint 错误变成警告。我们可以利用 RUSTFLAGS 环境变量将参数带给 Rust 编译器。所以原本的 cargo build 指令就要改写为:
RUSTFLAGS="--cap-lints=warn" cargo build
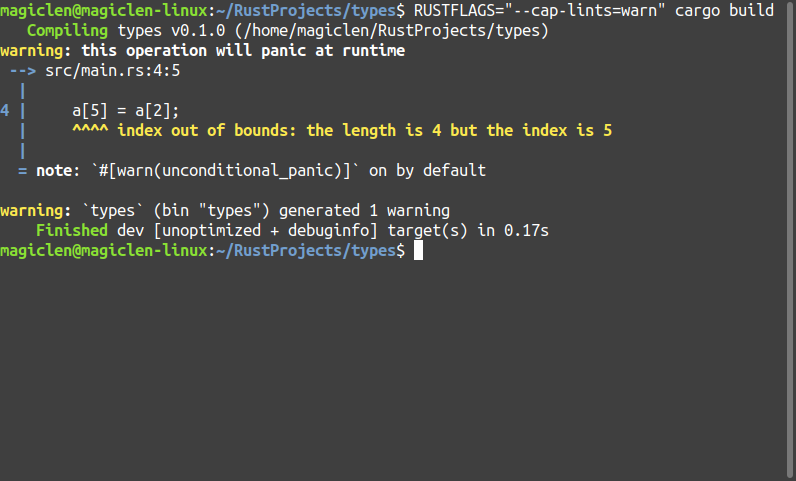
此处只是为了演示程序运行阶段才出现的错误,在实际使用上我们最好不要用这样的方式来使程序通过编译。因为这样的程序虽然通过编译,但在运行阶段还是会出问题的。
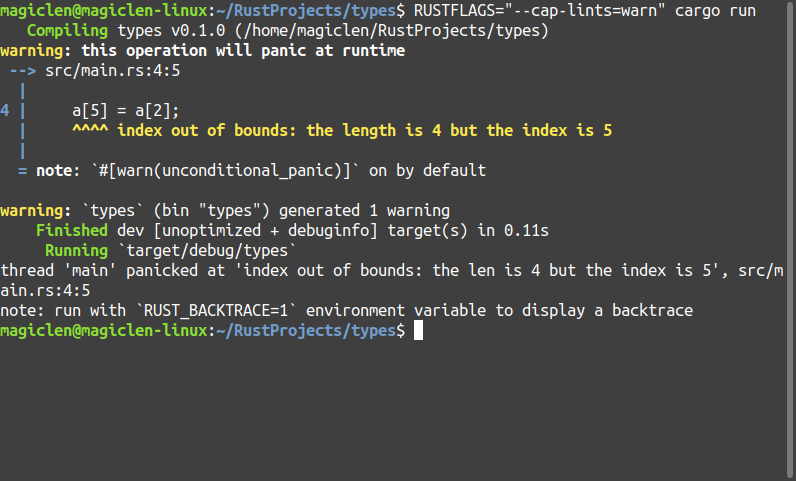
不过,从上图可以发现,当索引值超出数组范围时,程序会在运行阶段发生 panic。这其实也表示,Rust 编程语言在程序运行阶段还是会去维护数组的长度范围,虽然会消耗一些运算资源,但这样的作法会比如 C、C++ 这样的底层语言,它们在当索引值超出数组范围时还能继续操作内存,来得安全许多。
如果要创建出一个固定长度的数组,但数组元素目前还无法确定的话,也可以直接将数组写成:
[每个字段的初始元素值; 数组长度]
举例来说:
fn main() {
    let mut a = [0; 4];

    a[0] = 1;
    a[1] = 2;
    a[2] = 3;
    a[3] = 4;
}
函数
编程语言最重要的观念就是函数啦!我们先前已经有使用过 fn 关键字来定义 main 函数,并且也知道 main 函数为特别的函数,被用来作为程序一开始运行的函数。若要创建出新的函数,同样使用 fn 关键字,格式如下:
fn 函数名称(参数名称和类型) {
    主体的程序叙述
}
例如:
fn another_function(name: &str) {
    println!("Hi, {name}.");
}
Rust 编程语言并未限制定义函数的顺序。举例来说,以下两个程序都是可以编译的:
fn main() {
    another_function("world");
}

fn another_function(name: &str) {
    println!("Hi, {name}.");
}
fn another_function(name: &str) {
    println!("Hi, {name}.");
}

fn main() {
    another_function("world");
}
函数的名称和参数的类型可以组合成函数的「签名」。Rust 编程语言不支持函数多载(overloading),在同一个作用域下不能定义多个名称相同的函数,所以编译器只会依照函数名称来找到要调用的函数,再检查传入的值的类型是否符合签名中参数的类型。以上面的程序来说,在 main 函数中调用了 another_function("world"),编译器会找到我们定义的 another_function(name: &str) 函数,由于写在代码中的字符串的类型为 &str,与参数 name 的类型相符,因此可以通过编译,运行后会印出 Hi, world.。
定义函数时使用的大括号 {} 包裹住的区块为函数的主体,该区块可由一行或多行叙述组成,且最后一行的叙述如果不加分号,表示会回传该叙述的值。事实上,这整个主体区块也可以看作是程序叙述的表达式(expression),且不限于使用在 fn 关键字。举例来说:
fn main() {
    let x = {
        let y = 10;
        let z = 4;

        println!("y = {y}, z = {z}");

        y + z
    };

    println!("x = {x}");
}
以上程序第 2 行到第 9 行,我们也使用了大括号 {} 定义了一个新的程序区块。在这个区块中,会先印出 y = 10, z = 4,然后计算并回传变量 y 和变量 z 的结果。而这个回传的结果会指派给 main 函数的 x 变量,最后再印出 x = 14。
如果要定义一个有回传值的函数,同样是使用 fn 关键字,只不过需要多加上回传值的型态。如下:
fn 函数名称(参数名称和类型) -> 回传值的型态{
    主体的程序叙述
}
我们在函数的签名和主体之间,多加了 -> 符号来定义函数回传值的型态。利用这样的语法,来将上面的 x=y+z 程序改写看看:
fn main() {
    let x = x(10, 4);

    println!("x = {x}");
    // println!("x = {}", x(10, 4));
}

fn x(y: i32, z: i32) -> i32 {
    println!("y = {y}, z = {z}");

    y + z
}
以上程序第 2 行,将 x 函数的回传值指派给声明出来的变量 x。虽然变量和函数的用法不同,但如果都定义成相同名称的话,也是会无法一起使用。第 5 行如果解除注解,程序就会编译失败。而第 2 行因等号右边的程序会先运行的关系,所以调用 x 函数时还没有将 x 变量声明出来,因此可以编译成功。
常数函数
函数也可以使用 const 关键字来修饰,变成常数函数。常数函数可以在编译阶段就被运行,因此无法在主体中去使用在运行阶段才能够确定的东西。
建议尽量使用常数函数来让程序在编译阶段就用编译器把能够先完成的工作完成!
以下是一个常数函数例子:
fn main() {
    println!("x = {}", x(10, 4));
}

const fn x(y: i32, z: i32) -> i32 {
    y + z
}
不过要注意的是,以上程序第 2 行的 x(10, 4) 并不是在常数上下文(const context)中被调用,所以此时的 x 函数就跟一般的函数一样,会在运行阶段才被运行,参数也可以传入在运行阶段才能够确定的值(编译器在优化程序时,还是有可能会直接把它算成 14)。常数函数只有在常数上下文中被调用时,才一定会在编译阶段就被编译器运行。例如:
const A: i32 = 10 + (x(10, 4) * 4);
// const B: i32 = 10 + (xx(10, 4) * 4); // compilation error

const fn x(y: i32, z: i32) -> i32 {
    y + z
}

fn xx(y: i32, z: i32) -> i32 {
    y + z
}
以上程序,x 是常数函数,可以被直接用于赋值给常数的表达式;而 xx 不是常数函数,所以它不能被这样用。
注解
Rust 编程语言的单行注解都是由 // 开头,直到该行结束。例如:
// So we're doing something complicated here, long enough that we need
// multiple lines of comments to do it! Whew! Hopefully, this comment will
// explain what's going on.
多行注解则是由 /* 开头,直到 */ 结束。例如:
/*
So we're doing something complicated here, long enough that we need
multiple lines of comments to do it! Whew! Hopefully, this comment will
explain what's going on.
*/
在代码中加入适当的注解可以让程序变得更容易理解。
流程控制
大部分的编程语言可以借由判断条件来决定要运行哪些程序,以及重复运行哪些程序。
if 条件表达式
Rust 编程语言提供了 if 关键字和 else 关键字,可以很方便地实作出带有条件判断功能的表达式。用法如下:
if 布尔值 {
    布尔值为true时运行的程序叙述区块
} else {
    布尔值为false时运行的程序叙述区块
}
else 关键字以及其之后的程序叙述区块可以省略不写。
举例来说:
fn main() {
    let number = 3;

    if number < 5 {
        println!("condition was true");
    } else {
        println!("condition was false");
    }
}
程序运行结果:
若将 number 变量的值改为 7。
fn main() {
    let number = 7;

    if number < 5 {
        println!("condition was true");
    } else {
        println!("condition was false");
    }
}
程序运行结果:
如果需要进行多个条件的判断,可以使用 else if 关键字。用法如下:
if 布尔值1 {
    布尔值1为true时运行的程序叙述区块
} else if 布尔值2 {
    布尔值2为true时运行的程序叙述区块
} else if 布尔值3 {
    布尔值3为true时运行的程序叙述区块
} else if 布尔值n {
    布尔值n为true时运行的程序叙述区块
} else {
    以上布尔值(布尔值1、布尔值2、布尔值3、...、布尔值n)均为false时运行的程序叙述区块
}
else 关键字以及其之后的程序叙述区块可以省略不写。
举例来说:
fn main() {
    let number = 6;

    if number % 4 == 0 {
        println!("number is divisible by 4");
    } else if number % 3 == 0 {
        println!("number is divisible by 3");
    } else if number % 2 == 0 {
        println!("number is divisible by 2");
    } else {
        println!("number is not divisible by 4, 3, or 2");
    }
}
程序运行结果:
由于 if 关键字实作出来的代码结构,可整体看作是一个表达式,可以利用大括号 {} 程序叙述区块内,最后一进程式叙述不加分号的语法直接回传数值。
举例来说:
fn main() {
    let condition = true;
    let number = if condition {
        5
    } else {
        6
    };

    println!("The value of number is: {number}");
}
程序运行结果:
因为在不管什么条件下都一定要回传数值,因此这样的 if 结构用法必须要有 else 关键字,并且回传值的型态都要一致,否则会编译失败。
循环
循环可以让相同的程序自动运行一次以上,Rust 编程语言提供了 loop、while、for 关键字来创建用途不同的循环。
loop 循环
loop 关键字所创建的循环,必须在循环的程序区块内明确使用 break 叙述来脱离循环,否则会一直重复运行下去。用法如下:
loop {
    要重复运行的程序叙述区块
}
举例来说:
fn main() {
    loop {
        println!("again!");
    }
}
以上程序运行之后,程序将会不停地将 again! 文字一行一行地印在屏幕上。在 CLI(命令行界面)模式下,可以使用快速键 Ctrl + c 来中断程序的运行。
如果将程序改写成:
fn main() {
    loop {
        println!("again!");

        break;
    }
}
我们在程序第 5 行加入了 break 叙述,因此程序在运行之后,只会印出一行 again! 文字,然后就跳出循环,结束运行了。
如果只是要跳过这次循环的运行,直接到下一次的话,可以使用 continue 叙述。举例来说:
fn main() {
    let mut number = 0;

    loop {
        number += 1;

        if number % 2 == 0 {
            println!("{number}");
        } else {
            continue;
        }

        println!("check if number == 10");

        if number == 10 {
            break;
        }
    }
}
以上程序中的第 5 行,number += 1 其实就是 number = number + 1。
运行结果为:
check if number == 10
4
check if number == 10
6
check if number == 10
8
check if number == 10
10
check if number == 10
while 循环
while 关键字所创建的循环可以借由判断布尔值来决定要不要脱离循环。用法如下:
while 布尔值 {
    布尔值为true时要重复运行的程序叙述区块
}
举例来说:
fn main() {
    let mut number = 3;

    while number != 0 {
        println!("{number}!");

        number = number - 1;
    }

    println!("LIFTOFF!!!");
}
以上程序,当 number 变量不等于 0 的时候就会一直运行 while 循环内的程序叙述。运行结果如下:
2!
1!
LIFTOFF!!!
while 循环内的程序叙述区块也可以使用 break 和 continue 叙述。
for 循环
先继续刚才介绍的 while 循环,我们可以利用 while 循环来走访一个数组。例如:
fn main() {
    let a = [10, 20, 30, 40, 50];
    let mut index = 0;

    while index < 5 {
        println!("the value is: {}", a[index]);

        index += 1;
    }
}
程序运行结果:
the value is: 20
the value is: 30
the value is: 40
the value is: 50
虽然程序运行结果是正确的,但这样的实作方式经常会不小心因为数组长度没有设好或算好,超出范围而导致程序发生 panic。而且就算是使用正确长度,这样的写法运行效率也不是很好,原因我们在先前有提到,那就是 Rust 会去检查数组的索引值有没有超出范围再去访问。为了增加安全性和增进性能,可以使用 for 关键字实作的循环来走访数组,用法如下:
for 变量名称 in 数组.iter() {
    要重复运行的程序叙述区块
}
iter 方法是数组类型内置的方法,会回传一个 Iter 结构实体,作为迭代器(Iterator)。
改写刚才的 while 循环:
fn main() {
    let a = [10, 20, 30, 40, 50];

    for element in a.iter() {
        println!("the value is: {element}");
    }
}
另外也可以将数组参考直接作为迭代器使用。如下:
fn main() {
    let a = [10, 20, 30, 40, 50];

    for element in &a {
        println!("the value is: {element}");
    }
}
除了使用数组本身提供的迭代器之外,for 循环也可以搭配范围(range)语法所产生的某数值范围的迭代器来使用。用法如下:
for 变量名称 in 数值范围最小值..数值范围最大值+1 {
    要重复运行的程序叙述区块
}
举例来说:
fn main() {
    for number in 1..4 {
        println!("{number}!");
    }

    println!("LIFTOFF!!!");
}
程序运行结果:
2!
3!
LIFTOFF!!!
这里要注意到范围语法的数值范围最大值必须要加一,才会真正走访到数值范围的最大值。1..4 语法表示的范围为「1~3」;2..6 语法表示的范围为「2~5」。如果要刚好让范围语法能够走访到数值范围最大值,而不必特别加一的话,可以加上等于 = 字符。用法如下:
for 变量名称 in 数值范围最小值..=数值范围最大值 {
    要重复运行的程序叙述区块
}
1..=4 语法表示的范围为「1~4」;2..=6 语法表示的范围为「2~6」。
另外,迭代器也可以对相同数据提供许多不同的走访方法,例如 rev 方法可以颠倒走访顺序。如下:
fn main() {
    for number in (1..4).rev() {
        println!("{number}!");
    }

    println!("LIFTOFF!!!");
}
程序运行结果:
2!
1!
LIFTOFF!!!
迭代器的 enumerate 方法可以在走访数据的同时,去计算目前是第几次迭代。如下:
fn main() {
    for (index, number) in (1..4).enumerate() {
        println!("{index}: {number}!");
    }

    println!("LIFTOFF!!!");
}
程序运行结果:
1: 2!
2: 3!
LIFTOFF!!!
总结
在这个章节中,我们学会了 Rust 编程语言的变量、数据类型、函数、注解以及条件和循环的流程控制。在下一章节中,我们将会学习 Rust 编程语言跟其它大部份编程语言不一样的概念:拥有权(ownership)。
下一章:了解拥有权(Ownership)。