

在建置 Cargo 程序项目的时候,我们可以轻易地使用 cargo build 或是 cargo build --release 指令,来对开发(development)或是发布/部署(deployment)的目的做区分。cargo build 编译出来的二进制文件没有经过优化,而且会激活 #[cfg(debug_assertions)] 属性,来使用调试(debug)相关的代码;cargo build --release 则允许使用编译器所有的优化功能,并禁用有加上 #[cfg(debug_assertions)] 属性的代码。不过 cargo build --release 实际上并不一定会去激活所有的优化功能,有些优化项目还是需要靠其它编译器参数来激活才行。这些编译优化参数,究竟有什么实质影响呢?这篇文章将会对性能、文件大小和编译时间进行探讨。
为了方便进行我们的编译优化研究,先来制作一个简单的 Cargo 程序项目吧!
首先用以下指令来创建一个名为 crc64sum 的 Cargo 应用程序项目:
项目内容如下:
[package]
name = "crc64sum"
version = "0.1.0"
edition = "2021"

[dependencies]
crc-any = "2"
use std::{
    error::Error,
    fs::File,
    io::{self, Read},
};

use crc_any::CRCu64;

pub struct Config {
    filepath: String,
}

impl Config {
    pub fn new(filepath: String) -> Config {
        Config {
            filepath,
        }
    }
}

pub fn compute_file_crc(mut file: File) -> Result<u64, io::Error> {
    let mut crc64_ecma = CRCu64::crc64();

    let mut buffer = [0u8; 256];

    loop {
        let c = file.read(&mut buffer)?;

        if c == 0 {
            break;
        }

        crc64_ecma.digest(&buffer[..c]);
    }

    Ok(crc64_ecma.get_crc())
}

pub fn run(config: Config) -> Result<(), Box<dyn Error>> {
    let file = open_file(&config.filepath)?;

    let crc_value = compute_file_crc(file)?;

    println!("{crc_value:x}");

    Ok(())
}

fn open_file(filepath: &str) -> Result<File, io::Error> {
    File::open(filepath)
}
use std::{env, error::Error};

use crc64sum::*;

fn main() -> Result<(), Box<dyn Error>> {
    let config = Config::new(env::args().nth(1).ok_or("not enough arguments")?);

    crc64sum::run(config)?;

    Ok(())
}
crc64sum 是一个指令工具,可以利用 CRC64-ECMA 算法去计算某个文件的校验码(checksum)。
Debug 与 Release
笔者习惯将用 cargo build 指令编译程序的方式称为「Debug 编译模式」;用 cargo build --release 指令编译程序的方式称为「Release 编译模式」。
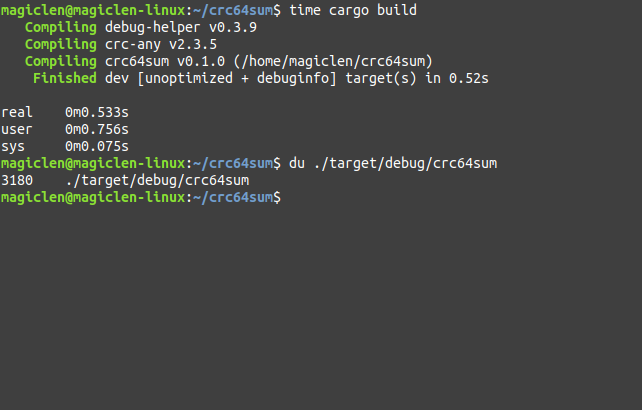
如下图,若直接使用 Debug 编译模式来建置 crc64sum 项目,所花的时间为 0.533 秒,最终产生 3180 KB 的可执行文件。
如下图,若使用 Release 编译模式来建置 crc64sum 项目,所花的时间为 0.548 秒,最终产生 2808 KB 的可执行文件。
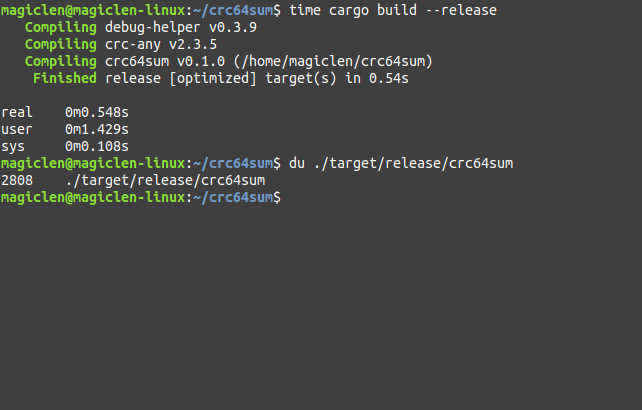
可以发现,Release 编译模式所花费的编译时间要比 Debug 编译模式还要来得长(具体长多久并不一定,程序项目规模愈大,会让 Release 编译模式所需的时间比 Debug 编译模式还要长愈多倍),产生出来的可执行文件也会比较小。
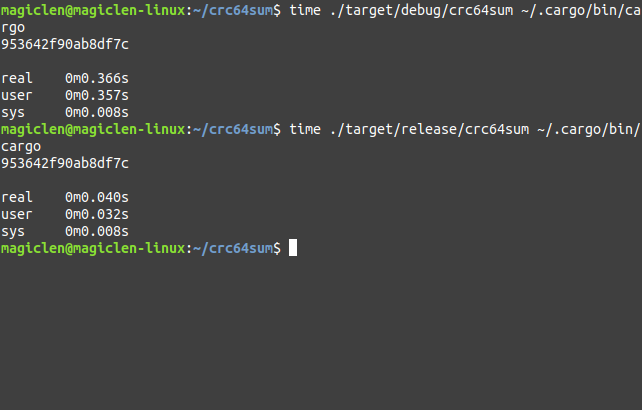
接着来比较这两个可执行文件的性能。例如去计算 cargo 可执行文件的 CRC 校验码,Debug 模式编译出来的可执行文件需要 0.366 秒;Release 模式编译出来的可执行文件只需要 0.040 秒。结果如下图:
opt-level
在 Cargo.toml 的 [profile.dev] 区块和 [profile.release] 区块可以设置 opt-level 项目,分别对 Debug 编译模式和 Release 编译模式设置不同的优化等级。
opt-level 可以有以下几种设置值:
0:不进行优化。1:允许基本优化。2:允许常用的优化。3:允许所有的优化。"s":允许常用的优化,外加一些能缩小体积的优化。"z":类似"s",但更偏重于体积的优化(可能会降低性能)。
Debug 编译模式预设使用 0;Release 编译模式预设使用 3。
LTO (Link Time Optimization)
LTO 顾名思义就是在程序编译后的链接阶段时所采取的优化行为,通常可以顺带减少编译出来的二进制文件的体积,但也会显著增加编译时间和占用的内存,且有时对程序性能并没有正面的影响,所以 Cargo 程序项目在建置时预设并没有激活 LTO。
Rust 提供的 LTO 分为 thin 和 fat 两种,可以被视为两种不同的 LTO 实作,彼此编译出来的程序并没有绝对的性能优劣(在绝大部份情况下,打开 LTO 编译出来的程序之性能会比没打开 LTO 还要来得好)。但以编译速度来说,thin 似乎总是比 fat 还要来得快。
在 Cargo.toml 的 [profile.release] 区块可以设置 lto 项目,在 Release 编译模式下激活 LTO。
例如以下设置可以激活 LTO(fat):
[profile.release]
lto = true
此时使用 Release 模式编译 crc64sum 项目需要花 1.867 秒才能编译完成,最终产生的可执行文件大小只有 1128 KB。
例如以下设置可以激活 ThinLTO:
[profile.release]
lto = "thin"
此时使用 Release 模式编译 crc64sum 项目需要花 1.466 秒才能编译完成,最终产生的可执行文件大小只有 1212 KB。
搭配 opt-level = "s" 或 opt-level = "z",还可以再让编译出来的文件变得更小。
Parallel Code Generation Units
在 Cargo.toml 的 [profile.release] 区块可以设置 codegen-units 项目,来指定编译器在编译一个 crate 的时候要将其切分成多少份来同时处理。默认值是 16 或 256,若改成 1,则不进行切分,以增加套用更多的优化的机会,提升程序性能,但可能会让编译时间上升。
例如以下设置:
[profile.release]
codegen-units = 1
此时使用 Release 模式编译 crc64sum 项目需要花 0.746 秒,最终产生的可执行文件大小为 2804 KB。
inline
Rust 内置 #[inline] 属性,可以手动建议(非强制)编译器去对某个函数进行内联(inline)处理,将函数的实作展开(拷贝)至调用这个函数的地方。内联的目的在于减少函数调用的次数,以避免创建堆栈框(Stack Frame)而有额外的开支(overhead)。对于一个体积极小(例如只有一个表达式)、需要进行快速计算或是为使代码易读而从某个函数中切分出来的函数,我们可以将其加上 #[inline] 属性,使它们在编译的时候可以在被调用的位置上展开。
另外还有 #[inline(always)] 属性,可以让编译器总是对该函数做内联,使其更像是类函数(function-like)宏。#[inline(never)] 属性,则可以告诉编译器不对这个函数做内联的动作,方便调试。
strip
不管是在 Debug 编译模式还是 Release 编译模式,编译好的二进制档都会带有调试信息。如果我们想让 Rust 在 Release 编译模式下编译出来的二进制档中不带有不必要的标头和调试信息,在 Cargo.toml 的 [profile.release] 区块可以将 strip 项目设为 true。
如下:
[profile.release]
strip = true
当编译出来的可执行文件需要公开发布(publish)时,还可以搭配 panic = "abort" 一同使用,这部份可以参考这篇文章。
如果只是要个人使用或是在组织内部使用的话,将调试信息和 unwinding panic 机制保留下来对日后维护会比较方便。此外,如果不想让线程发生 panic 就让整个程序直接中断的话,就不能使用 panic = "abort",不过还是可以使用 strip = true。