

插补搜索(Interpolation Search)算法又称为内插搜索算法,是二元搜索(Binary Search)算法的变体。这套算法可以在已排序好的串行中根据数据的预测线或近似线来进行高效率的搜索,近似线愈精准,搜索的效率就愈高。
插补搜索法(Interpolation Search)
插补搜索法的概念
插补搜索法是基于二元搜索法的算法,如果您还不了解二元搜索法的话,请先参考这篇文章:
插补搜索法不像二元搜索法每次都选择串行搜索范围的中间元素,而是借由目前搜索范围的近似线公式来导出要搜索的元素可能会存在或是可能比较接近的索引位置。举例来说,若我们知道该搜索范围的串行数据可以用直线方程式 #{{ y = x + 1 }}# 来表示的话,其中 #{{y}}# 是元素值,#{{x}}# 是索引值,那么我们可以利用要查找的元素值 #{{y}}# 来直接计算出其索引值 #{{x}}#,#{{x = y - 1}}#,如此一来这个串行的搜索时间复杂度就会是 #{{O(1)}}#。
当然,现实中的数据不太可能都刚好是线性的。所以我们会使用「线性近似」的手段,选取几个点来计算出数据的近似线,在这线段上的数据即为内插。内插值虽然可能不会刚好是原始的数据值,但至少可以接近原始的数据值。
如下图,红线是蓝线数据的近似线。
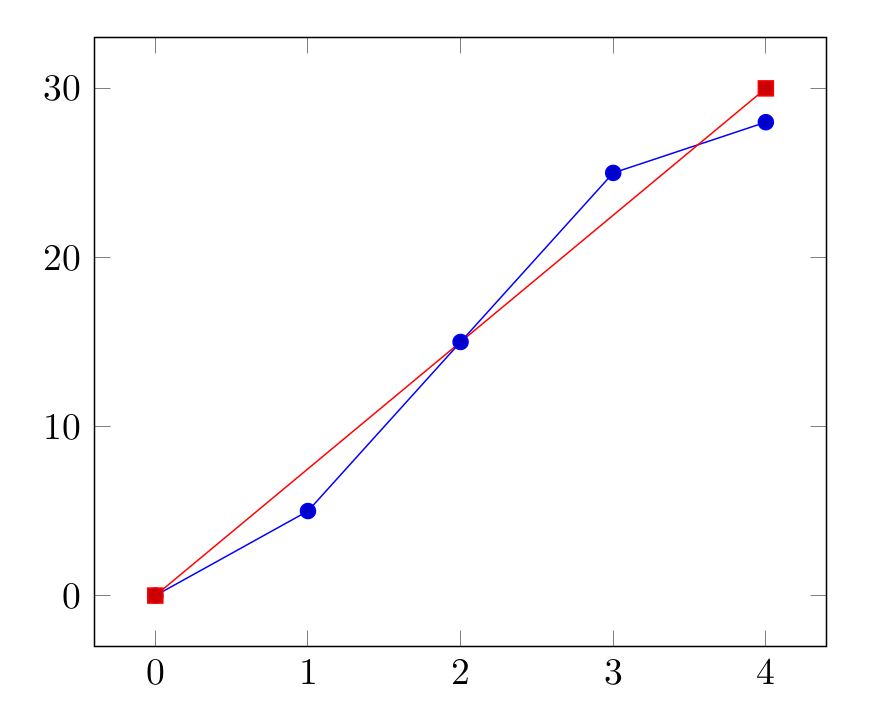
插补搜索法所使用的近似线公式所求出来的索引值功用就如同二元搜索法的中间索引值,也就是说,若索引值所对应的元素值比要查找的元素值还大的话,下一次搜索的串行范围就是此次搜索的串行范围的前段(值小的那段);若索引值所对应的元素值比要查找的元素值还小的话,下一次搜索的串行范围就是此次搜索的串行范围的后段(值大的那段)。在搜索不同串行范围时所使用的近似线公式需重新计算,最简单取得近似线公式的方式就是利用搜索范围中的首、尾两个点来求出直线公式。
将首点表示为 #{{(x_1, y_1)}}#,将尾点表示为 #{{(x_2, y_2)}}#,可以求出直线公式为:
#{{{ {y - y_1} = { {y_2 - y_1} \over {x_2 - x_1} } (x - x_1) }}}#
移项之后:
#{{{ x = { {(y - y_1)(x_2 - x_1)} \over {y_2 - y_1} } + x_1 }}}#
以上的 #{{x}}# 即为要读取的串行索引值,当然因为算出来不一定是整数,所以需要舍弃小数点或者进位。
插补搜索法的过程
假设现在有个已排序好的整数数组,内容如下:
索引    0   1   2   3   4   5   6   7   8   9
数值    2   9  30  32  38  47  61  69  79  81
然后我们要用插补搜索法来找到元素 61。
       ●                                  ●
索引    0   1   2   3   4   5   6   7   8   9
数值    2   9  30  32  38  47  61  69  79  81
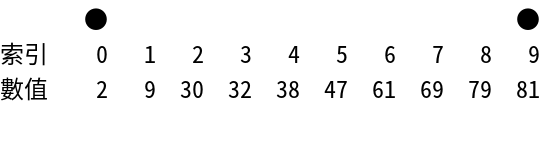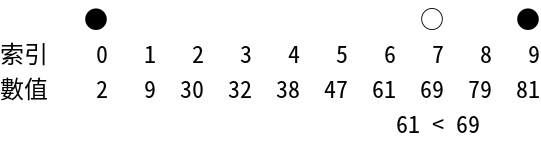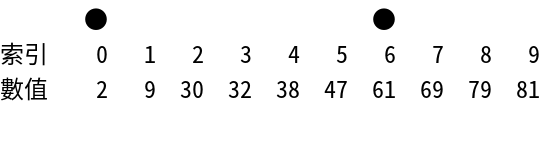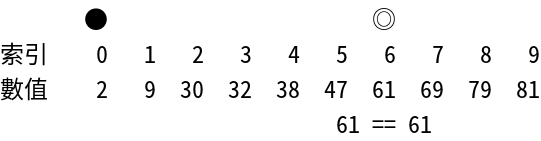
所以一开始选择的索引值为:
#{{{ x = { {(61 - 2)(9 - 0)} \over {81 - 2} } + 0 \approx 6.7215 \approx 7 }}}#
       ●                          ○      ●
索引    0   1   2   3   4   5   6   7   8   9
数值    2   9  30  32  38  47  61  69  79  81
                                 61 < 69

       ●                      ●
索引    0   1   2   3   4   5   6   7   8   9
数值    2   9  30  32  38  47  61  69  79  81
接下来选到的索引值为:
#{{{ x = { {(61 - 2)(6 - 0)} \over {61 - 2} } + 0 = 6 }}}#
       ●                      ◎
索引    0   1   2   3   4   5   6   7   8   9
数值    2   9  30  32  38  47  61  69  79  81
                            61 == 61
成功找到元素 61 在串行中索引 6 的位置!
插补搜索法的程序实作
插补搜索法的复杂度
以 #{{n}}# 来表示要搜索的数据笔数。
| 项目 | 值 | 备注 |
|---|---|---|
| 最差时间复杂度 | #{{O(n)}}# | 数据分布不均,近似线差异太大时。 |
| 最佳时间复杂度 | #{{O(1)}}# | 近似线公式直接算出正确的索引值。 |
| 平均时间复杂度 | #{{O(\log \log n)}}# | 数据分布均匀时。 |
| 最差空间复杂度(递归) | #{{O(n)}}# | |
| 最差空间复杂度(迭代) | #{{O(1)}}# |