

费氏搜索(Fibonacci Search)算法有点像是二元搜索(Binary Search)算法,同样是在一个已排序好的数组中搜索元素,但是它在移动数组索引值时是去参考费氏数列(Fibonacci Sequence),而不是像二元搜索法那样总是去取索引的中间值。也由于费氏搜索法在移动数组索引值时只需要进行加减运算,不需乘、除法,因此它适合被用在不擅长处理乘、除法的 CPU 上。
费氏搜索法(Fibonacci Search)
费氏搜索法的概念
费氏数列(Fibonacci Sequence)
费氏数列又称费布那西(Fibonacci)数列,它是一种发散数列,第 1 项的值为 0,第 2 项的值为 1,第 #{{n}}# 项(#{{ n \geq 3 }}#)的值为第 #{{n - 1}}# 项和第 #{{n - 2}}# 项的总和。费氏数列看起来会长得像以下这样:
0, 1, 1, 2, 3, 5, 8, 13, 21, 34, 55, 89, 144, 233, ...
以数学函数 #{{F(n)}}# 来表示费氏数列的第 #{{n}}# 项数值,可以写成:
#{{{
\begin{alignedat}{2}
F(1) &{}={}&& 0 \\
F(2) &{}={}&& 1 \\
F(n) &{}={}&& F(n - 1) + F(n - 2), \text{where } n \geq 3 \\
\end{alignedat}
}}}#
不过由于写程序习惯从 0 开始数,所以最好还是将费氏数列的第一项设计为 #{{F(0)}}#,也就是:
#{{{
\begin{alignedat}{2}
F(0) &{}={}&& 0 \\
F(1) &{}={}&& 1 \\
F(n) &{}={}&& F(n - 1) + F(n - 2), \text{where } n \geq 2 \\
\end{alignedat}
}}}#
这篇文章之后都会用 #{{F(0)}}# 作为费氏数列的第一项。
费氏树(Fibonacci Tree)与二元搜索树(BST, Binary Search Tree)
设一二元树(Binary Tree)任意节点的数值为整数 #{{n}}#,且 #{{n > 0}}#。若 #{{n > 1}}#,则其左边子节点的数值为 #{{n - 1}}#,右边子节点的数值为 #{{n - 2}}#;若 #{{n = 1}}#,则该节点没有子节点。所以这个二元树长出来的结果会像下面这个样子:
             5
            / \
           /   \
          /     \
         /       \
        /         \
       4           3
      / \         / \
     /   \       /   \
    3     2     2     1
   / \   /     /
  2   1 1     1
 /
1
如果我们利用这个二元树的节点值去取得费氏数列中对应第几项的数值,取代原先的节点值。会得到如下的二元树:
             5
            / \
           /   \
          /     \
         /       \
        /         \
       3           2
      / \         / \
     /   \       /   \
    2     1     1     1
   / \   /     /
  1   1 1     1
 /
1
这个就是费氏树啦!透过上面画出的费氏树,不难发现,根节点为 #{{F(5)}}# 的费氏树,其根节点左边的子树,就是根节点为 #{{F(4)}}# 的费氏树;而根节点为 #{{F(5)}}# 的费氏树,其根节点右边的子树,就是根节点为 #{{F(3)}}# 的费氏树。换句话说,根节点为 #{{F(n)}}# 的费氏树,其根节点左边的子树,就是根节点为 #{{F(n - 1)}}# 的费氏树;而根节点为 #{{F(n)}}# 的费氏树,其根节点右边的子树,就是根节点为 #{{F(n - 2)}}# 的费氏树。
费氏树其实也就是费氏数列的二元递归(Binary Recursion)函数的递归树(Recursion Tree)。
题外话,设 #{{S(n)}}# 为根节点为 #{{F(n)}}# 的费氏树的节点数量,则 #{{S(n) = S(n - 1) + S(n - 2) + 1}}#,且 #{{S(1) = 1}}#、#{{S(2) = 2}}#。有没有觉得这东西很像是费氏数列?还真的可以用费氏数列来换算如下(不晓得怎么算出来的,但是可以由等等会介绍的二元搜索树推出来):
#{{{
S(n) = F(n + 2) - 1
}}}#
那费氏树和费氏搜索法有什么关联吗?
我们可以保留费氏树的节点关系(节点的位置),先不看节点值,将它当作是一个二元搜索树。
二元搜索树是一种二元树。节点如果有左边子节点的话,其左边子节点连接的所有值都必须要小于该节点的值;节点如果有右边子节点的话,其右边子节点连接的所有值都必须要大于或等于该节点的值。例如以下结构即为二元搜索树:
        7
       / \
      /   \
     /     \
    /       \
   3         9
  / \       / \
 /   \     /   \
1     5   8     9
 \   / \
  2 4   6
利用从费氏树上保留下来的节点关系,从 0 开始逐次加 1,按照二元搜索树的规则覆写费氏树的所有节点值,会得到如下的二元搜索树:
             7
            / \
           /   \
          /     \
         /       \
        /         \
       4          10
      / \         / \
     /   \       /   \
    2     6     9    11
   / \   /     /
  1   3 5     8
 /
0
有没有发现?以上的二元搜索树任意节点与其左、右子节点的差之绝对值都是一样的。从根节点 7 开始看的话,会发现一直往左(逐渐变小)的差是 #{{F(4)}}#、#{{F(3)}}#、#{{F(2)}}#、#{{F(1)}}#、#{{F(0)}}#(无子节点)这样变化的(费氏数列的项数每次减 1);而一直往右(逐渐变大)的话会发现差是 #{{F(4)}}#、#{{F(2)}}#、#{{F(0)}}#(无子节点)这样变化的(费氏数列的项数每次减 2)。所以,若这一次移动时是往左,则下一次移动时,费氏数列的项数就要先减 1;若这一次移动时是往右,则下一次移动时,费氏数列的项数就要先减 2。注意这边的先后顺序,并不是比较完大小之后,就去依照往左或往右来看要费氏数列的项数是要减 1 还是减 2 来移动索引值。来做个错误示范,比如说要走到 6 好了,若费氏数列的项数初始化为 5,7 到 6 要先往左,把费氏数列的项数减 1,计算出下一次的索引值是 4 (#{{7 - F(5 - 1) = 7 - 3 = 4}}#),接着 4 到 6 要先往右,把费氏数列的项数减 2,计算出下一次的索引值是 5 (#{{4 + F(4 - 2) = 4 + 1 = 5}}#)……这样就错了!下一次的索引值应为 6 才对。
用这样的方式产生的二元搜索树其实就是费氏搜索法分治(Divide)数组索引值的方式。(如果您不太懂这句的意思,可以先看下一小节以二元搜索法举的例子)
假如要搜索的数组 a 长度是 12,其分治方式就正好是上面这棵树!一开始先去看 a[7],如果要找的元素比 a[7] 大,下一次就去看 a[10];如果要找的元素比 a[7] 小,下一次就去看 a[4],依此类推。当遇到 #{{F(0)}}# 的时候,如果还没有找到要找的元素,就表示该元素不在这个数组中。
那么问题就来了,我们要如何用程序产生出这棵二元搜索树?当然,我们其实只需要知道这棵二元搜索树的根节点,以及根节点与其子节点的差是费氏数列的第几项就够了,因为剩下的可以利用费氏数列从根节点去算。
仔细观察二元搜索树各层最左边的节点,其实它们就是费氏数列(于最底层从 #{{F(2)}}# 开始),只不过被减 1 了!也就是说,我们其实可以直接借由数组的长度(节点的数量),来产生这棵二元搜索树。
继续以长度为 12 的数组为例,由于我们知道某个费氏数列的值(再减 1)会刚好就是二元搜索树的根节点,且也知道根节点的右子树它必定不会再包含其它的费氏数列的值(再减 1)。因此,利用长度 12 去寻找在费氏数列中,等于或是小于 12 的最大费氏数。该数(再减 1)就会是二元搜索树的根节点值,该数的项数再减 2 就是根节点与其子节点的差是费氏数列的第几项。
那如果数组的长度不是 12,而是 9 呢?按照上面的方式来建二元搜索树,根本就是会建出与数组长度为 12 时一模一样的东西嘛!那些「不存在」的索引要怎么办?……遇到不存在的索引(超出数组范围的索引值)时,直接往左子树移动即可。
(很多网站提供的费氏搜索法的算法和代码很古怪,不晓得在算什么,应该要按照上述的方式来算才是有意义的。)
二元搜索法的二元搜索树与时间复杂度
再补充一下上面提到的二元搜索树究竟是什么用途。如果您还不了解二元搜索法的话,请先参考这篇文章:
若长度为 13 的数组 a 要用二元搜索法来搜索元素的话,因为是二元搜索法,所以一开始会先取中间的索引值,也就是 6,来看 a[6] 是不是要找的元素,如果要找的元素比较大,就去看数组的右半段。右半段也是要先切半,右半段中间的索引值会是 9,看 a[9] 是不是要找的元素……就这样依此类推,把每次切半所得到的数组索引值记下来,画成二元搜索树,就是以下的样子:
           6
          / \
         /   \
        /     \
       /       \
      /         \
     /           \
    2             9
   / \           / \
  /   \         /   \
 /     \       /     \
0       4     7      11
 \     / \     \     / \
  1   3   5     8  10  12
二元搜索树的每一层代表进行一次的元素比较,所以二元搜索法元素最高的比较次数为如上的二元搜索树的层数,这也就是为什么它的最差时间复杂度为 #{{ O({\log_{(2)}n}) }}# 了。
而既然费氏搜索法也画得出类似的二元搜索树,我们就知道它的时间复杂度其实也跟二元搜索树差不多(忽略产生费氏数列的复杂度)。
题外话,二元搜索法的二元搜索树任意节点之左右子树的节点数量之比为 1:1,而费氏树的平均比为黄金比例 1.618:1。当然,对于在已排序好的数组中搜索元素的应用来说,还是二元搜索法切割的比例更为合理。对比二元搜索法,费氏搜索法的优势仅在于它只需要加减运算。
费氏搜索法的过程
假设现在有个已排序好的整数数组,内容如下:
索引    0   1   2   3   4   5   6   7   8
数值    2   9  30  32  38  47  61  69  79
然后我们要用费氏搜索法来找到元素 79。
首先,利用数组的长度来找出二元搜索树的根节点。这个数组的长度是 9,因此在费氏数列中寻找到最大但小于或等于 9 的费氏数吧!
若已经有这个「费氏数列」,那就只要做单纯的搜索并找出项数就好了。若还没有这个「费氏数列」,那就要产生出来,产生的过程如下:
○  ◎  ●
 0   1   1

○  ◎  ●
 0   1   1
      9 >= 1

    ○  ◎  ●
 0   1   1   2(1 + 1)


    ○  ◎  ●
 0   1   1   2
          9 >= 2

        ○  ◎  ●
 0   1   1   2   3(1 + 2)


        ○  ◎  ●
 0   1   1   2   3
              9 >= 3

            ○  ◎  ●
 0   1   1   2   3   5(2 + 3)


            ○  ◎  ●
 0   1   1   2   3   5
                  9 >= 5

                ○  ◎  ●
 0   1   1   2   3   5   8(3 + 5)


                ○  ◎  ●
 0   1   1   2   3   5   8
                      9 >= 8

                    ○  ◎   ●
 0   1   1   2   3   5   8   13(5 + 8)


                    ○  ◎   ●
 0   1   1   2   3   5   8   13
                           9 < 13

                    ○  ◎   ●
 0   1   1   2   3   5   8   13
根据以上的过程,我们找出了 8 这个在费氏数列中最大但小于或等于 9 的费氏数,同时也找出了 8 的前一项 5 和下一项 13。
有了费氏数列的连续三项,之后就可以轻易地算出这连续三项前、后的数值。(在费氏搜索法中只需要用到之前的项)
接着就要开始按照费氏搜索法之二元搜索树的路径来进行元素比较,并且移动索引值。
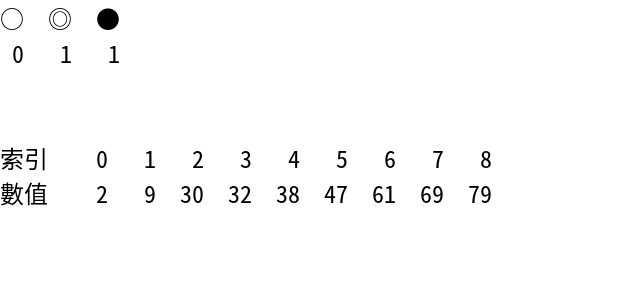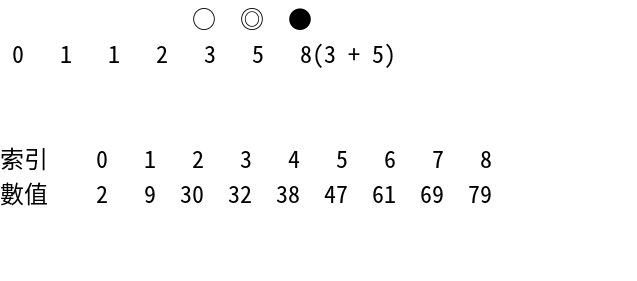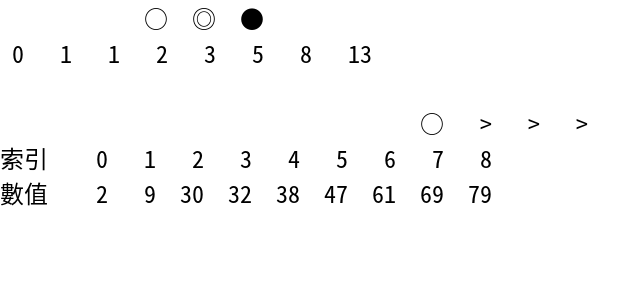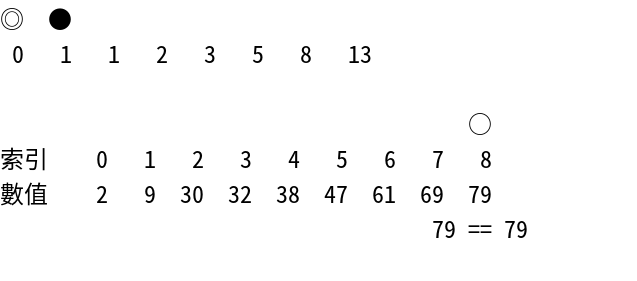
首先,先计算比较后,数组索引要往右或往左移动的距离。根据前面介绍的概念,这个距离会是「费氏数列中最大但小于或等于长度的费氏数」再往前 2 项的费氏数。所以要利用刚才找到的连续三项费氏数列来推算往前两项的结果,如下:
             <   <  ○  ◎   ●
 0   1   1   2   3   5   8   13

            ○  ◎  ●
 0   1   1   2   3   5   8   13
可知之后数组索引应该要往右或往左移动 3 个距离。
那么就开始进行比较吧!
             7


                                   ○
索引    0   1   2   3   4   5   6   7   8
数值    2   9  30  32  38  47  61  69  79
                                 79 > 69
由于我们要找的元素 79 比索引 7 的元素值 69 还要来得大,所以下一次搜索所用的索引值是根节点右边子节点的索引值,也就是 7 + 3 = 10。
然后计算之后数组索引要往右或往左移动的距离。根据前面介绍的概念,由于这次的比较是往右,这个距离会是目前费氏数再往前 2 项的费氏数。所以要利用已知的连续三项费氏数列来推算往前两项的结果,如下:
     <   <  ○  ◎  ●
 0   1   1   2   3   5   8   13

    ○  ◎  ●
 0   1   1   2   3   5   8   13
可知之后数组索引应该要往右或往左移动 1 个距离。
那么就开始进行比较吧!由于比较时要看的索引值是 10,超出数组范围了。
             7
              \
               \
                \
                 \
                  \
                  10


                                               ○
索引    0   1   2   3   4   5   6   7   8
数值    2   9  30  32  38  47  61  69  79
所以直接计算左边子节点的值,也就是 10 - 1 = 9。
然后计算之后数组索引要往右或往左移动的距离。根据前面介绍的概念,由于这次是往左,这个距离会是目前费氏数再往前 1 项的费氏数。所以要利用已知的连续三项费氏数列来推算往前一项的结果,如下:
 <  ○  ◎  ●
 0   1   1   2   3   5   8   13

○  ◎  ●
 0   1   1   2   3   5   8   13
可知之后数组索引应该要往右或往左移动 1 个距离。
那么就开始进行比较吧!由于比较时要看的索引值是 9,超出数组范围了。
             7
              \
               \
                \
                 \
                  \
                  10
                  /
                 /
                9


                                           ○
索引    0   1   2   3   4   5   6   7   8
数值    2   9  30  32  38  47  61  69  79
所以直接计算左边子节点的值,也就是 9 - 1 = 8。
然后计算之后数组索引要往右或往左移动的距离。根据前面介绍的概念,由于这次是往左,这个距离会是目前费氏数再往前 1 项的费氏数。所以要利用已知的连续三项费氏数列来推算往前一项的结果,如下:
○  ◎  ●
 0   1   1   2   3   5   8   13

◎  ●
 0   1   1   2   3   5   8   13
可知之后数组索引应该要往右或往左移动 0 个距离。换句话说,若下次比较时还是无法找到要找的元素,该元素就不在这个数组中。
那么就开始进行比较吧!比较时要看的索引值是 8,如下:
             7
              \
               \
                \
                 \
                  \
                  10
                  /
                 /
                9
               /
              8


                                       ○
索引    0   1   2   3   4   5   6   7   8
数值    2   9  30  32  38  47  61  69  79
                                    79 == 79
如此一来就找到元素 79 了,其存在于数组中的索引 8 的位置。如何?挺快的吧!
费氏搜索法的程序实作
费氏搜索法的复杂度
以 #{{n}}# 来表示要搜索的数据笔数。
| 项目 | 值 | 备注 |
|---|---|---|
| 最差时间复杂度 | #{{O(\log n)}}# | 元素不在串行中且元素大小刚好是某些特定值,或者刚好遇到要搜索的元素位于特定的串行索引值。忽略产生费氏数列的时间复杂度。 |
| 最佳时间复杂度 | #{{O(1)}}# | 要查找的元素的索引值刚好是费氏数列中最大但小于或等于串行长度的费氏数再减 1。忽略产生费氏数列的时间复杂度。 |
| 平均时间复杂度 | #{{O(\log n)}}# | 忽略产生费氏数列的时间复杂度。 |
| 最差空间复杂度 | #{{O(1)}}# | 永远只记录费氏数列的连续三项。 |