FFmpeg 全名是 Fast Forward MPEG (Moving Picture Experts Group),为开源的影音多媒体处理框架,可以进行影音的解码、编码、编码转换、混合、抽取、串流和滤镜,无论影音格式是从哪个地方出来的,从过去到现在的影音格式它几乎都能够支持。在录制声音或是合成声音之后,为了避免音量太小声,或是与其它段的声音音量差距太大,所以还需要再替声音做「范式」(normalization)的动作,而 FFmpeg 也能够被用来处理声音的范式。
峰值范式
峰值范式(Peak Normalization)是以该段声音中波形振幅最大的位置为参考点,将整段声音整体放大或缩小,使该段声音中波形振幅最大的位置移动到指定的准位上。与峰值范式十分相像的还有有效值范式(RMS Normalization),它的参考点就不是选在波形振幅最大的位置上,而是以整个波形的音量有效值(或者称均方根值,Root Mean Square)准位作为参考点,然后同样将整段声音的音量整体放大或缩小,使得该段声音的音量有效值移动到指定的准位上。
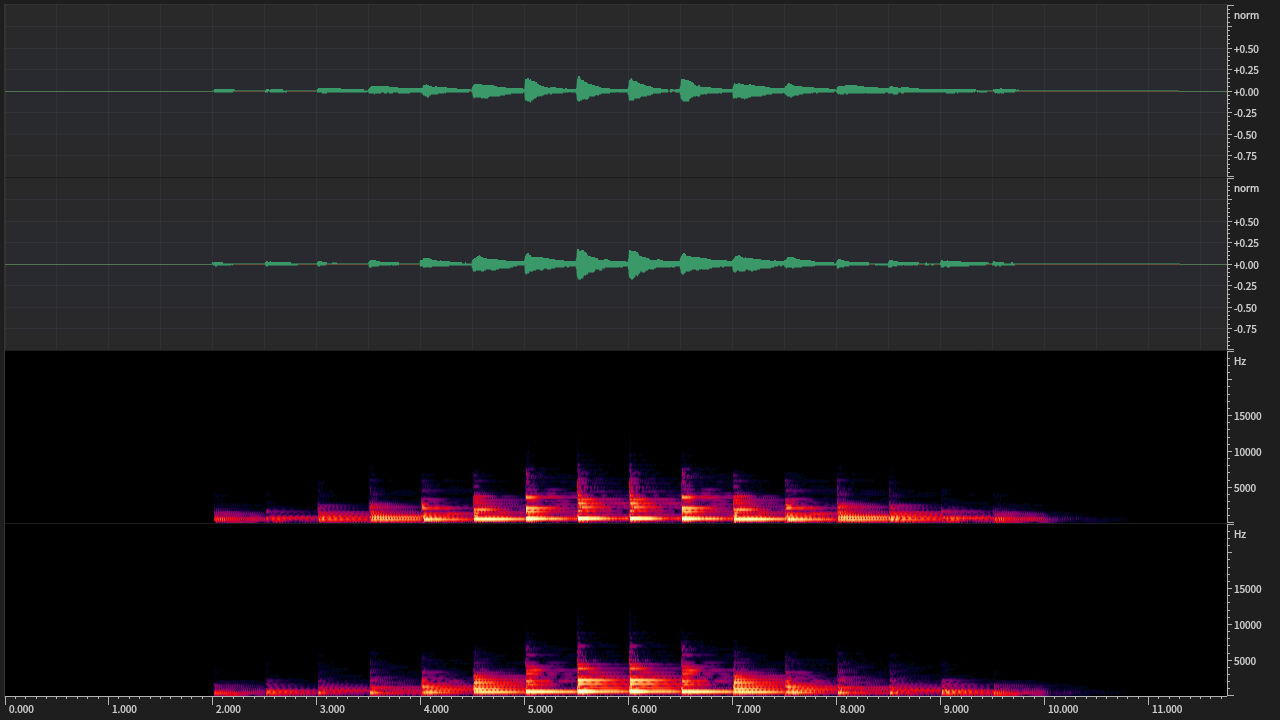
举例来说,下图是一段音量偏小的声音的波形:
而下图是这段声音经过峰值范式后音量放大的波形:
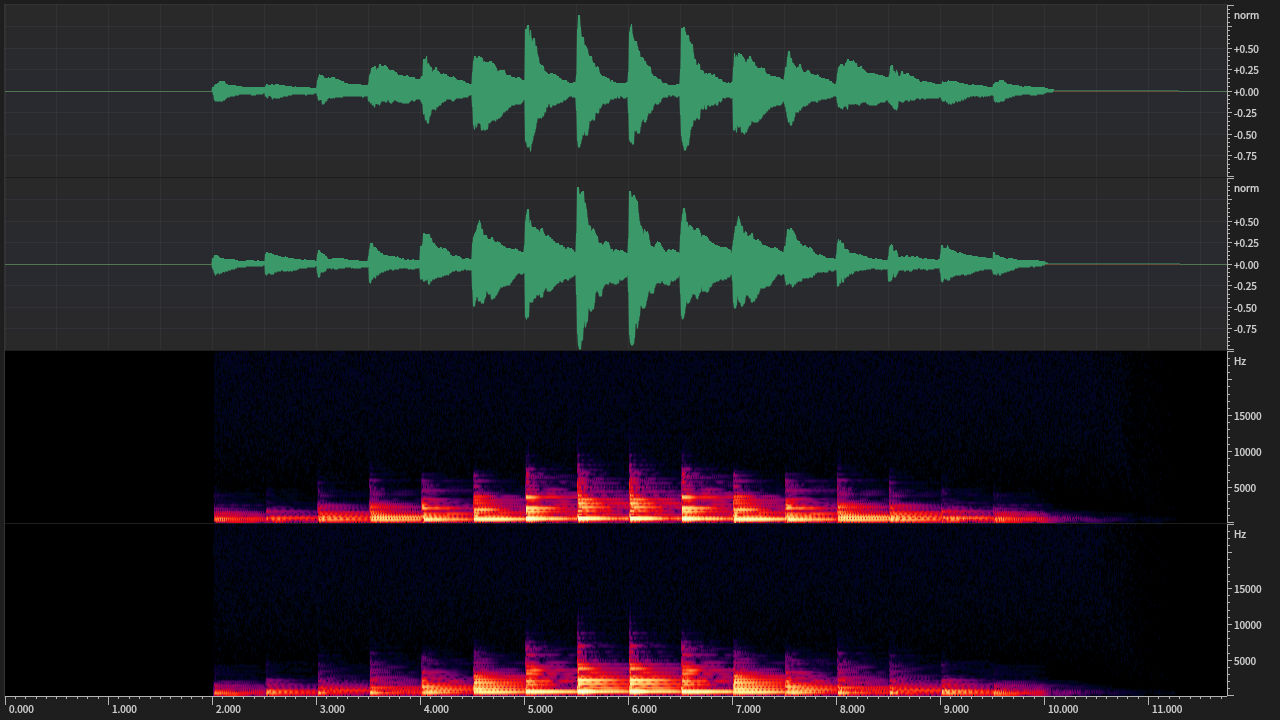
如果您看波形图没什么感觉的话,可以比较一下这个声音在峰值范式前后的差异:
如何?能听出来峰值范式后,音量增大了许多吗?就像是把音乐播放器音量调大了一样。
在使用峰值范式的时候,只要我们不把波形振幅最大的位置移动到超出数字可表示的音量最大值,这个波形就不会发生爆音(clip)而失真。但是在使用有效值范式时,即便我们设置音量有效值在处理后不超过音量最大值,还是有可能会使得原本音量大于有效值的位置在被放大后超过音量最大值而失真。峰值范式是最简单实用的范式方式。
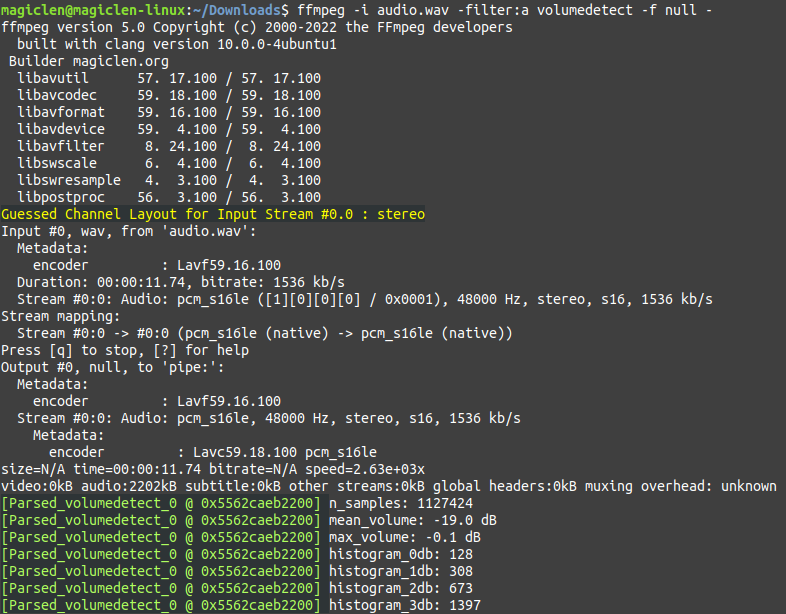
要使用 FFmpeg 来进行峰值范式,需要运行二次的处理。第一次要先找出整段声音的音量最大值,指令如下:
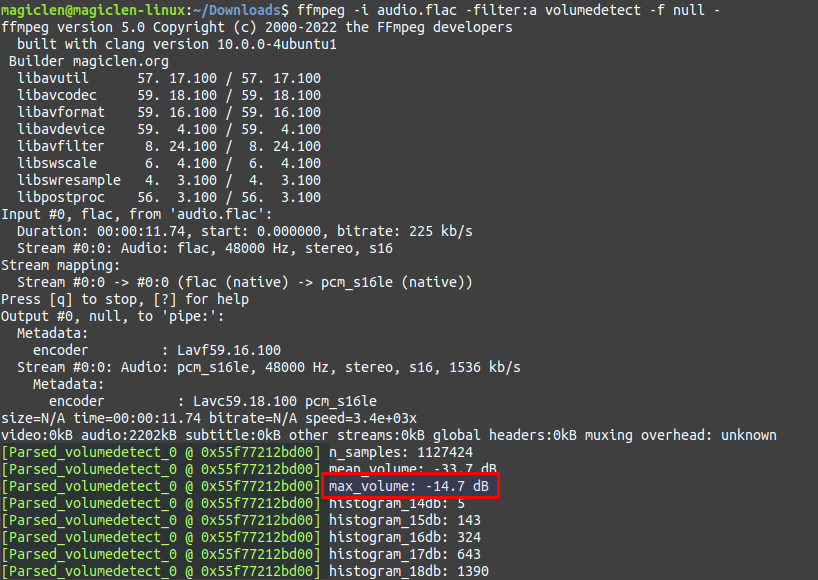
指令运行后,我们需要关注的是 max_volume 值。如上图红框所在的地方,显示 -14.7dB,表示该段声音中波形振幅最大的位置还要再放大 +14.7dB 才能够到达音量最大值。为了避免影音播放器、编码器本身会将音量放大而造成失真,通常我们会让声音在做峰值范式时,将峰值指定在 0 ~ -3dB。在这里以 -0.1dB 为例,若要把需要放大 +14.7dB 才能够到达音量最大值的声音放大 +14.6dB,指令如下:
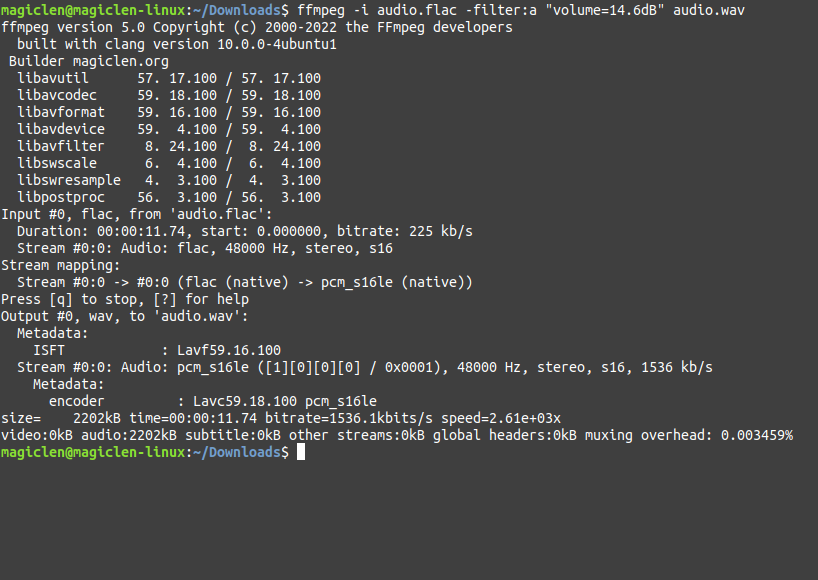
如此便能得到 max_volume 值在 -0.1dB 的声音。
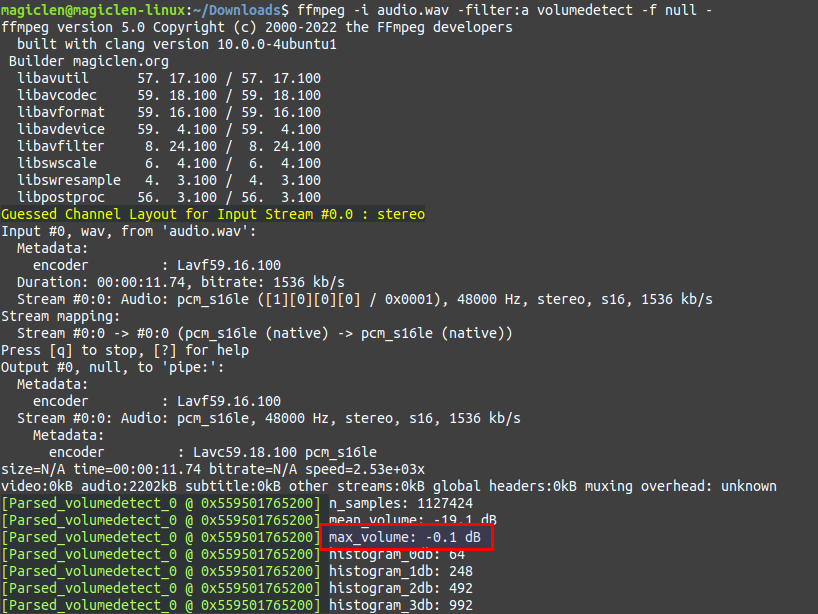
以上的两行指令在 Unix-like 环境下也可以缩短成为一行,如下:
INPUT_FILE=/path/to/input-audio-file; ffmpeg -i "$INPUT_FILE" -filter:a "volume=$(ffmpeg -i "$INPUT_FILE" -filter:a volumedetect -f null - 2>&1 | grep max_volume | awk -F " " '{print -$(NF-1) - 0.1}')dB" /path/to/output-audio-file
以上指令,0.1 表示要让输出的声音之 max_volume 值为 -0.1dB。
响度范式
响度范式(Loudness Normalization)是以「人」感知到的音量大小作为参考点(非物理上的声波振幅),将整段声音的各部份放大或缩小,使得该段声音听起来的响度是在指定的准位上。
为什么要做这件事情?
起因与广播电视的节目有关,当观众或听众切换不同的频道,或是从一个节目进到下一个节目、从节目进广告,甚至是在同一个节目之中,如果音量有明显的变化,他们就需要经常去调节设备播放出来的音量,不太方便也破坏体验。因此会需要对响度订一个统一的标准,让它能在同样的准位上变化,且变化范围也要有所限制,不然太大声就会爆音,太小声又会听不到。
欧洲广播联盟(EBU, European Broadcasting Union)在 ITU-R BS.1770 标准的基础之上,对响度的演算细节作了更明确的定义,订定出了 EBU R.128 标准。FFmpeg 提供支持 EBU R.128 的 loudnorm 滤镜,但是在使用前还有一些概念需要先提及:
- 响度与声波振幅并没有绝对的关系,最大响度不一定会出现在最大振幅的位置。
- LU (Loudness Unit):响度的相对单位。1 LU = 1 dB。
- LUFS (Loudness Unit Full Scale):响度绝对单位。1 LUFS = 1 dBFS。最大响度是
0 LUFS,最大响度的一半就是-3 LUFS。 - I (Integrated Loudness):整体响度。以 LUFS 为单位。不同类型的声音会有不同的响度建议值,例如音乐为 -14 LUFS,广播为 -23 LUFS。
- TP (True Peak):真正的峰值。为了避免最大振幅出现在数字采样点之间(inter-sample peak),所以用过采样(oversampling)的方式来创建波形,最大振幅的位置即为 TP。
- LRA (Loudness Range):响度的变化范围,最大响度和最小响度的差异(有一定比例的最大声和最小声的部份不会被列入分析)。原则上,在愈吵杂的环境下,LRA 愈小,体验会更好。不同类型的音乐或声音对于响度变化范围的要求也不同。
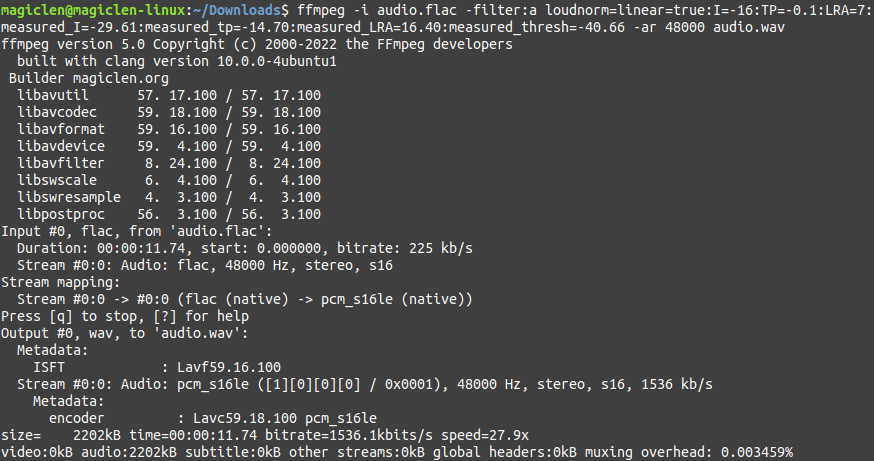
要使用 FFmpeg 来进行响度范式,需要运行二次的处理。第一次要先找出整段声音的 I、TP、LRA 等等的数值,指令如下:
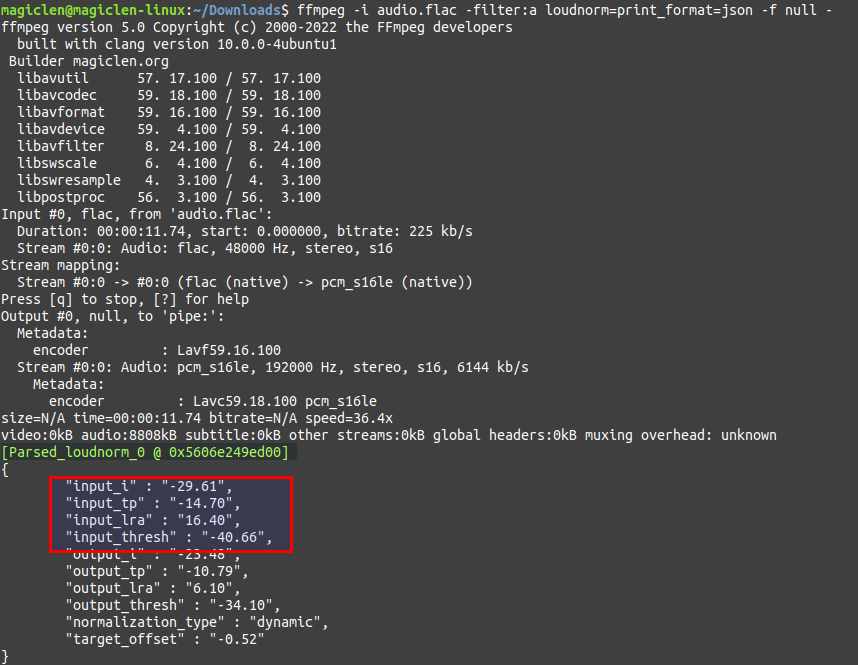
分析结果会以 JSON 格式文字直接印在标准输出(stdout)中,我们需要看的字段有 input_i、input_tp、input_lra、input_thresh。thresh 值,笔者也不太确定是什么,或许是响度低于这个值的话就被视为无声,而不会列入分析吧?
接着运行以下格式的指令,来输出新的音频。
如以上的指令格式,请把第一次处理时得到的 input_i、input_tp、input_lra、input_thresh 数值填进指令中,接着调整 I、TP 和 LRA 的数值,再于 -ar 参数后设置要输出的采样频率(如果不设置的话会是 192KHz)。