图(graph)是由节点(node)和边(edge)组合而成的非线性结构,如果我们想要从其中的一个节点开始,走访到其有直接或是间接连接的其它所有节点,可以依靠深度优先搜索法(DFS, Depth-first Search)或是广度优先搜索法(BFS, Breadth-first Search)来达成。
文件系统的结构其实就是树状(tree)结构,而树属于图的一种,所以文件系统也适用于深度优先搜索和广度优先搜索。就拿文件搜索来说明深度优先搜索和广度优先搜索有什么不同吧!
我们都知道,文件可以细分为:有子文件的「目录」和没有子文件的「文件」。假设有个目录的文件结构是以下这个样子:
pictures
 ├── animals
     ├── a1.jpg
     └── a2.jpg
 └── plants
     ├── p1.jpg
     └── p2.jpg
试想一下,当我们想要用文件浏览器查看一个 pictures 目录底下,包含其子目录下的所有文件时,会是怎么样的情形。
如果是使用深度优先搜索法的话,只要看到目录就会立刻点入。所以我们在点入 pictures 目录后,接着看到 animals 目录,基于深度优先搜索法的原则,我们会立刻点入 animals 目录。再来我们就会看到 a1.jpg 和 a2.jpg 文件。然后回到上一页,也就是 pictures 目录后,看到 animals 目录之后的 plants 目录,我们继续点入,就会看到 p1.jpg 和 p2.jpg 文件。
而如果是使用广度优先搜索法的话,必须要看完一层目录后,才会再看下一层。所以我们在点入 pictures 目录后,虽然首先会看到 animals 目录,但基于广度优先搜索法的原则,我们还要先继续看 pictures 目录中的其它文件,所以接下来会再看到 pictures 目录中还有 plants 目录。再来就是点入 animals 目录,就会看到其中有 a1.jpg 和 a2.jpg 文件。然后回到上一页,也就是 pictures 目录后,点入 plants 目录,就会看到其中有 p1.jpg 和 p2.jpg 文件。
深度优先搜索法和广度优先搜索法随着应用方式的不同,程序实作方式也会有很大的差异,不过概念就像是以上这样。
树的深度优先搜索和广度优先搜索
树的深度优先搜索和广度优先搜索之过程
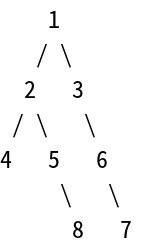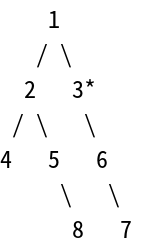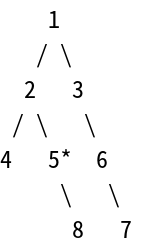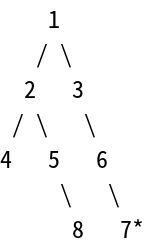
假设现在有个树状数据,内容如下:
    1
   / \
  2   3
 / \   \
4   5   6
     \   \
      8   7
我们想要在这个树中找出数值 6。以下将分别探讨其在深度优先搜索和广度优先搜索时的过程。
深度优先搜索
首先从树根也就是数值 1 的位置开始。
    1*
   / \
  2   3
 / \   \
4   5   6
     \   \
      8   7
因为数值 1 不等于数值 6,所以再从数值 1 这个节点的底下节点来找。
然后看到数值 2 的这个节点。
    1
   / \
  2*  3
 / \   \
4   5   6
     \   \
      8   7
因为数值 2 不等于数值 6,然后又要深度优先的关系,所以再从数值 2 这个节点的底下节点来找。
然后看到数值 4 的这个节点。
    1
   / \
  2   3
 / \   \
4*  5   6
     \   \
      8   7
因为数值 4 不等于数值 6,然后又要深度优先的关系,所以再从数值 4 这个节点的底下节点来找。
但是数值 4 这个节点底下已经没有子节点了,所以会跳去看数值 5 这个节点。
    1
   / \
  2   3
 / \   \
4   5*  6
     \   \
      8   7
因为数值 5 不等于数值 6,然后又要深度优先的关系,所以再从数值 5 这个节点的底下节点来找。
然后看到数值 8 的这个节点。
    1
   / \
  2   3
 / \   \
4   5   6
     \   \
      8*  7
因为数值 8 不等于数值 6,然后又要深度优先的关系,所以再从数值 8 这个节点的底下节点来找。
但是数值 8 这个节点底下已经没有子节点了,且数值 5 和数值 2 也都没有其它还没看过的节点,所以会跳去看数值 3 这个节点。
    1
   / \
  2   3*
 / \   \
4   5   6
     \   \
      8   7
因为数值 3 不等于数值 6,然后又要深度优先的关系,所以再从数值 3 这个节点的底下节点来找。
然后看到数值 6 的这个节点。
    1
   / \
  2   3
 / \   \
4   5   6*
     \   \
      8   7
数值 6 正是我们要找的节点!
下面这个动画演示了整棵树使用深度搜索来走访所有节点过程:
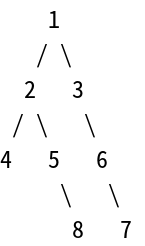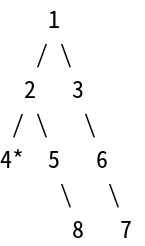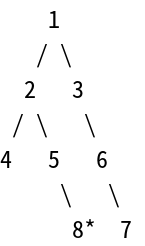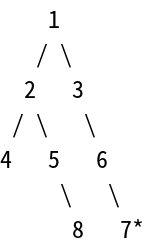
广度优先搜索
首先从树根也就是数值 1 的位置开始。
    1*
   / \
  2   3
 / \   \
4   5   6
     \   \
      8   7
因为数值 1 不等于数值 6,所以再从数值 1 这个节点的底下节点来找。
然后看到数值 2 的这个节点。
    1
   / \
  2*  3
 / \   \
4   5   6
     \   \
      8   7
因为数值 2 不等于数值 6,然后又要广度优先的关系,所以再继续从数值 1 这个节点的底下节点来找。
然后看到数值 3 的这个节点。
    1
   / \
  2   3*
 / \   \
4   5   6
     \   \
      8   7
因为数值 3 不等于数值 6,然后又要广度优先的关系,所以再继续从数值 1 这个节点的底下节点来找。
但是数值 1 这个节点的子节点都已经被看过了,所以会跳去看数值 2 这个节点底下的子节点。
然后就会看到数值 4 的这个节点。
    1
   / \
  2   3
 / \   \
4*  5   6
     \   \
      8   7
因为数值 4 不等于数值 6,然后又要广度优先的关系,所以再继续从数值 2 这个节点的底下节点来找。
然后看到数值 5 的这个节点。
    1
   / \
  2   3
 / \   \
4   5*  6
     \   \
      8   7
因为数值 5 不等于数值 6,然后又要广度优先的关系,所以再继续从数值 2 这个节点的底下节点来找。
但是数值 2 这个节点的子节点都已经被看过了,所以会跳去看数值 3 这个节点底下的子节点。
然后就会看到数值 6 的这个节点。
    1
   / \
  2   3
 / \   \
4   5   6*
     \   \
      8   7
数值 6 正是我们要找的节点!
下面这个动画演示了整棵树使用广度搜索来走访所有节点过程:
树的深度优先搜索和广度优先搜索之实作
use std::{cell::RefCell, collections::LinkedList, rc::Rc};

#[derive(Debug)]
pub struct Node {
    pub value:    i32,
    pub children: Vec<Rc<RefCell<Node>>>,
}

impl Node {
    pub fn new(value: i32) -> Self {
        Node {
            value,
            children: Vec::new(),
        }
    }

    fn rc_equal(a: &Rc<RefCell<Node>>, b: &Rc<RefCell<Node>>) -> bool {
        let ref_a = a.borrow();
        let ref_b = b.borrow();

        std::ptr::eq(&*ref_a, &*ref_b)
    }

    pub fn is_child(&self, node: &Rc<RefCell<Node>>) -> bool {
        for child in self.children.iter() {
            if Self::rc_equal(node, child) {
                return true;
            }
        }

        false
    }

    pub fn add_adjacent_node(node: Rc<RefCell<Node>>, child: Rc<RefCell<Node>>) {
        let mut borrowed_node = node.borrow_mut();

        if !borrowed_node.is_child(&child) {
            borrowed_node.children.push(child.clone());
        }
    }
}

pub fn dfs_recursively(node: Rc<RefCell<Node>>, target_value: i32) -> Option<Rc<RefCell<Node>>> {
    let ref_node = node.borrow();

    if ref_node.value == target_value {
        return Some(node.clone());
    }

    for child in ref_node.children.iter() {
        if let Some(node) = dfs_recursively(child.clone(), target_value) {
            return Some(node);
        }
    }

    None
}

pub fn dfs(node: Rc<RefCell<Node>>, target_value: i32) -> Option<Rc<RefCell<Node>>> {
    let mut stack = Vec::new();

    stack.push(node);

    while let Some(node) = stack.pop() {
        let ref_node = node.borrow();

        if ref_node.value == target_value {
            return Some(node.clone());
        }

        for child in ref_node.children.iter().rev() {
            stack.push(child.clone())
        }
    }

    None
}

pub fn bfs(node: Rc<RefCell<Node>>, target_value: i32) -> Option<Rc<RefCell<Node>>> {
    let mut queue = LinkedList::new();

    queue.push_back(node);

    while let Some(node) = queue.pop_front() {
        let ref_node = node.borrow();

        if ref_node.value == target_value {
            return Some(node.clone());
        }

        for child in ref_node.children.iter() {
            queue.push_back(child.clone())
        }
    }

    None
}

pub fn bfs_2_stacks(node: Rc<RefCell<Node>>, target_value: i32) -> Option<Rc<RefCell<Node>>> {
    let mut stack_1 = Vec::new();
    let mut stack_2 = Vec::new();

    stack_1.push(node);

    loop {
        while let Some(node) = stack_1.pop() {
            let ref_node = node.borrow();

            if ref_node.value == target_value {
                return Some(node.clone());
            }

            for child in ref_node.children.iter() {
                stack_2.push(child.clone())
            }
        }

        while let Some(node) = stack_2.pop() {
            let ref_node = node.borrow();

            if ref_node.value == target_value {
                return Some(node.clone());
            }

            for child in ref_node.children.iter() {
                stack_1.push(child.clone())
            }
        }

        if stack_1.is_empty() {
            break;
        }
    }

    None
}
树的深度优先搜索和广度优先搜索之复杂度
以 #{{v}}# 来表示节点的数量。以 #{{e}}# 来表示边的数量。
| 项目 |
值 |
备注 |
| 最差时间复杂度 |
#{{O(v + e)}}# |
|
| 最佳时间复杂度 |
#{{O(1)}}# |
第一个走访到的节点就是我们想找的节点。 |
| 平均时间复杂度 |
#{{O(v + e)}}# |
|
| 最差空间复杂度 |
#{{O(v)}}# |
|
图的深度优先搜索和广度优先搜索
图的深度优先搜索和广度优先搜索的方式和树的差不多,但图的边可以是双向的,而且同一个节点可能会有许多个进入边(in-edge),所以图在使用深度优先搜索和广度优先搜索时,要另外去记录哪些节点已经走访过了,避免重复走访。
记录已走访的节点的方式有两种。第一种就是直接替节点多加一个字段,用来保存这个节点是否已经走访过,不过这个会有一些重用时要重设的问题。第二种是在搜索的时候,另外用一个结构去保存已经走访过的节点,不过这个方式可能会增加时间复杂度或是空间复杂度。
这篇文章将会选择使用第二种方式来实作图的深度优先搜索和广度优先搜索算法。
图的深度优先搜索和广度优先搜索之实作
use std::{
    cell::RefCell,
    collections::{HashSet, LinkedList},
    rc::Rc,
};

#[derive(Debug)]
pub struct Node {
    pub value:           i32,
    pub reachable_nodes: Vec<Rc<RefCell<Node>>>,
}

impl Node {
    pub fn new(value: i32) -> Self {
        Node {
            value,
            reachable_nodes: Vec::new(),
        }
    }

    fn rc_equal(a: &Rc<RefCell<Node>>, b: &Rc<RefCell<Node>>) -> bool {
        let ref_a = a.borrow();
        let ref_b = b.borrow();

        std::ptr::eq(&*ref_a, &*ref_b)
    }

    pub fn is_reachable_node(&self, node: &Rc<RefCell<Node>>) -> bool {
        for reachable_node in self.reachable_nodes.iter() {
            if Self::rc_equal(node, reachable_node) {
                return true;
            }
        }

        false
    }

    pub fn add_adjacent_node(node: Rc<RefCell<Node>>, reachable_node: Rc<RefCell<Node>>) {
        {
            let mut borrowed_node = node.borrow_mut();

            if !borrowed_node.is_reachable_node(&reachable_node) {
                borrowed_node.reachable_nodes.push(reachable_node.clone());
            }
        }

        {
            let mut borrowed_reachable_node = reachable_node.borrow_mut();

            if !borrowed_reachable_node.is_reachable_node(&node) {
                borrowed_reachable_node.reachable_nodes.push(node);
            }
        }
    }

    pub fn drop_graph(node: Rc<RefCell<Node>>) {
        let mut stack = Vec::new();

        stack.push(node);

        while let Some(node) = stack.pop() {
            let mut ref_node = node.borrow_mut();

            for reachable_node in ref_node.reachable_nodes.iter().rev() {
                stack.push(reachable_node.clone())
            }

            ref_node.reachable_nodes.clear();
        }
    }
}

pub fn dfs(node: Rc<RefCell<Node>>, target_value: i32) -> Option<Rc<RefCell<Node>>> {
    let mut visited: HashSet<*const Node> = HashSet::new();

    let mut stack = Vec::new();

    stack.push(node);

    while let Some(node) = stack.pop() {
        let ref_node = node.borrow();

        if ref_node.value == target_value {
            return Some(node.clone());
        }

        visited.insert(&*ref_node as *const Node);

        'outer: for reachable_node in ref_node.reachable_nodes.iter().rev() {
            if visited.contains(&(&*(reachable_node.borrow()) as *const Node)) {
                continue 'outer;
            }
            stack.push(reachable_node.clone())
        }
    }

    None
}

pub fn bfs(node: Rc<RefCell<Node>>, target_value: i32) -> Option<Rc<RefCell<Node>>> {
    let mut visited: HashSet<*const Node> = HashSet::new();

    let mut queue = LinkedList::new();

    queue.push_back(node);

    while let Some(node) = queue.pop_front() {
        let ref_node = node.borrow();

        if ref_node.value == target_value {
            return Some(node.clone());
        }

        visited.insert(&*ref_node as *const Node);

        'outer: for reachable_node in ref_node.reachable_nodes.iter() {
            if visited.contains(&(&*(reachable_node.borrow()) as *const Node)) {
                continue 'outer;
            }
            queue.push_back(reachable_node.clone())
        }
    }

    None
}
使用额外的 HashSet 结构来保存已经走访过的节点的指针,可以让空间复杂度和时间复杂度不会显著增加。


