

在一篇很长的文章或是一大串文字中找出自己想看到的段落是我们时常会需要做的事情,但是要如何有效率地让电脑寻找文字中的文字是一件需要思考的事情,甚至有许多针对这个议题所提出的研究论文。字符串搜索算法的好坏,在复杂的文档内容下,对搜索时间的影响是非常深远的。字符串搜索除了能够正确搜索一段文字内的特定字符串外,还可以用来搜索庞大的任意数据,因为任何的数据都可以借由数字编码转成只有数字的字符串,如一段原始的声音,一段原始的视频,甚至是一段生物基因。Boyer-Moore-MagicLen 是笔者结合 Boyer-Moore-Horspool 和 Quick Search Algorithm 得出的算法,这两种都是 Boyer-Moore (BM)算法的简化作法。
Boyer-Moore
Boyer-Moore 算法又称 BM 算法,它在开始搜索字符串之前,会先对搜索目标,也就是样本(pattern)进行预处理的动作,使得此算法之后在使用这个样本来在原文(text)中搜索字符串时,能够利用「好后缀位移」(good-suffix shift)和「坏字符位移」(bad-character shift),来想办法让目前无法与样本相匹配的文字索引位置,能够位移最多个字符的索引距离(若此算法同时计算了好后缀位移和坏字符位移,则会选择能够位移最多的那个),减少原文字符与样本字符的判断是否相同的次数,来加速字符串搜索(相对于暴力字符串搜索)。
所以什么是「好后缀」和「坏字符」呢?如果要用口语描述的话,「好后缀」为目前位置之样本和原文相符的字符串后缀;「坏字符」为目前位置之样本和原文从后面判断第一个出现的不相符字符,就是好后缀开头的前一个字符。
「好后缀位移」和「坏字符位移」的位移方式可以预先在尚未知道原文的时候,单靠样本来创建。创建好样本的「好后缀位移表」和「坏字符位移表」之后,无论遇到怎么样的原文,都可以使用这个样本和预先处理过的表格对原文进行非常快速的字符串搜索。
以 Boyer-Moore 算法的作者之一──Moore 所举的例子来说明,我们要搜索的原文如下:
HERE IS A SIMPLE EXAMPLE
然后要搜索的样本为 EXAMPLE。在经过预处理之后,我们已经有了「好后缀位移表」和「坏字符位移表」,因为有些复杂,这边就先不提预处理的方式。接着进入字符串搜索阶段,Boyer-Moore 算法会从原文的最前方开始,先判断样本的后缀是否和原文相匹配。
HERE IS A SIMPLE EXAMPLE
EXAMPLE
如上示例,可以看到原文第 7 个字符 S 和样本第 7 个字符 E 并不相同,此时的 S 称为「坏字符」,且因刚才没有一个字符是有匹配成功的,所以此时并没有「好后缀」。接下来 Boyer-Moore 算法就会利用 S 这个坏字符来计算出「坏字符位移」,我们可以把此时的「坏字符位移」直接想成是要把 EXAMPLE 这个样本往右移动最少几个索引值后,样本本身所含有的「坏字符」能和刚刚在原文中发现的「坏字符」对齐。
由于此时的「坏字符」是 S,而我们也知道 EXAMPLE 这个样本中并不存在「坏字符」S,所以我们不能完成「把 EXAMPLE 这个样本往右移动最少几个索引值后,样本本身所含有的『坏字符』能和刚刚在原文中发现的『坏字符』对齐」这件事。于是此时的「坏字符位移」的策略就会变成是要把 EXAMPLE 这个样本往右移动最少几个索引值后,样本的第 1 个字符会在原文的「坏字符」的下一个索引位置。并在位移之后,继续判断样本的后缀是否和原文相匹配。
HERE IS A SIMPLE EXAMPLE
       EXAMPLE
如上示例,可以看到原文第 14 个字符 P 和样本第 7 个字符 E 并不相同,此时的 P 称为「坏字符」,且因刚才没有一个字符是有匹配成功的,所以此时并没有「好后缀」。接下来 Boyer-Moore 算法就会利用 P 这个坏字符来计算出「坏字符位移」,使样本在往右移动最少的索引值后,样本本身所含有的「坏字符」能和刚刚在原文中发现的「坏字符」对齐。并在位移之后,继续判断样本的后缀是否和原文相匹配。
HERE IS A SIMPLE EXAMPLE
         EXAMPLE
如上示例,可以看到原文第 13 个字符到第 16 个字符 MPLE 和样本第 4 个字符到第 7 个字符是一样的,但是原文第 12 个字符 I 和样本第 3 个字符 A 就不相同了。此时的 I 称为「坏字符」,而 MPLE 称为「好后缀」。接下来 Boyer-Moore 算法就会利用 I 这个坏字符来计算出「坏字符位移」,使样本在往右移动多少个索引值后,样本的第 1 个字符会在原文的「坏字符」的下一个索引位置,计算出来的结果会是 3。而 Boyer-Moore 算法也会利用 MPLE 这个好后缀以及 PLE、LE 和 E 这几个延伸的好后缀来计算出「好后缀位移」,我们可以把此时的「好后缀位移」直接想成是要把 EXAMPLE 这个样本往右移动最少几个索引值后,样本本身所含有的「好后缀」或是延伸的好后缀能和刚刚在原文中发现的「好后缀」或是延伸的好后缀对齐。
首先看有没有办法在样本右移之后还能够有 MPLE 能够对齐,答案是没有。接着看有没有办法在样本右移之后还能够有 PLE 能够对齐,答案是依然没有。再来看有没有办法在样本右移之后还能够有 LE 能够对齐,还是没有。最后发现 E 是可以对齐到的,需要将样本向右移动 6 个索引值。
由于「坏字符位移」是 3,而「好后缀位移」是 6,因此 Boyer-Moore 算法会选择使用「好后缀位移」。并在位移之后,继续判断样本的后缀是否和原文相匹配。
HERE IS A SIMPLE EXAMPLE
               EXAMPLE
这边原文的 P 和样本的 E 不同,所以 Boyer-Moore 算法就会利用 P 这个坏字符来计算出「坏字符位移」,使样本在往右移动最少的索引值后,样本本身所含有的「坏字符」能和刚刚在原文中发现的「坏字符」对齐。并在位移之后,继续判断样本的后缀是否和原文相匹配。
HERE IS A SIMPLE EXAMPLE
                 EXAMPLE
如此一来就成功在原文中找到样本出现的位置了!
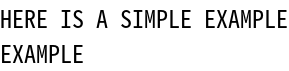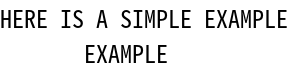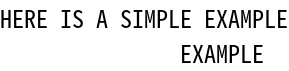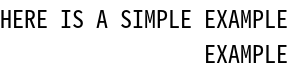
Boyer-Moore-Horspool
Boyer-Moore-Horspool 算法是 Boyer-Moore 算法的精简版本,它仅运用 Boyer-Moore 算法的「坏字符位移」概念来完成字符串的搜索,且如果样本匹配失败,则永远把正在匹配的原文范围中的最后一个字符当作是坏字符。
重新使用以上的例子,来演示处理过程:
HERE IS A SIMPLE EXAMPLE
EXAMPLE

HERE IS A SIMPLE EXAMPLE
       EXAMPLE

HERE IS A SIMPLE EXAMPLE
         EXAMPLE

HERE IS A SIMPLE EXAMPLE
               EXAMPLE

HERE IS A SIMPLE EXAMPLE
                 EXAMPLE
以上的过程是跟 Boyer-Moore 算法一样的,但背后的算法并不一样。
这套算法好像很奇怪,为什么样本匹配失败时,它可以「永远把正在匹配的原文范围中的最后一个字符当作是坏字符」?而不是以「好后缀开头的前一个字符」作为坏字符?这边有个逻辑上的跳跃思考,先假设 Boyer-Moore-Horspool 算法这样的作法是正确的,我们「把正在匹配的原文范围中的最后一个字符当作是坏字符」时,如果样本中没有这个字符,那么目前涵盖的这个范围的原文位置肯定不会是样本能够匹配的位置,所以就算我们的坏字符是选择「好后缀开头的前一个字符」,到最后也会得到跟「把正在匹配的原文范围中的最后一个字符当作是坏字符」时一样的结果,也就是最终这个范围的原文位置都会被跳过,所以倒不如一开始就直接「把正在匹配的原文范围中的最后一个字符当作是坏字符」,会省下一些位移的次数。
那如果是「把正在匹配的原文范围中的最后一个字符当作是坏字符」时(以下简称为前者),而样本中也有这个字符存在于其非最后一个索引位置的情况呢?如果此时我们的坏字符是选择「好后缀开头的前一个字符」(以下简称为后者),且样本中前面的索引位置也有这个字符的存在的话,若用后者作为坏字符所计算出来的位移量比前者还要小,可以推断以此距离位移后,原本原文匹配范围中的最后一个字符绝对不会与位移后样本中对应位置的字符相同,因为我们必须要让样本至少经过前者作为坏字符计算出来的位移量,才能够使原本原文匹配范围中的最后一个字符与位移后样本中对应位置的字符是相同的。但若用后者作为坏字符所计算出来的位移量比前者还要大时,不就也会遇到上述的问题吗?是的,当后者作为坏字符所计算出来的位移量比前者还要大时,就会导致位移次数的增加。
举例来说:
RPOIXYZABCDAEEFGHIJKLM
       ABCDEEE
使用 Boyer-Moore 算法的话,样本经过位移之后会变成:
RPOIXYZABCDAEEFGHIJKLM
           ABCDEEE
移动了四个索引值。
而使用 Boyer-Moore-Horspool 算法的话,样本经过位移之后会变成:
RPOIXYZABCDAEEFGHIJKLM
        ABCDEEE
只移动了一个索引值。
所以 Boyer-Moore 算法和 Boyer-Moore-Horspool 算法的性能是各有千秋吗?因为刚才不是还有提到当样本中不存在坏字符的情形时,是使用「正在匹配的原文范围中的最后一个字符当作是坏字符」来计算位移会比较好吗?虽然是这样没错,但别忘了 Boyer-Moore 算法还有一个「好后缀位移」。如果是在这个情形下,也必定不能在样本的前段索引范围中发现好后缀或是好后缀的延伸。所以也是一样,不管用 Boyer-Moore 算法还是 Boyer-Moore-Horspool 算法,这个范围的原文位置都会被跳过。
因此,Boyer-Moore 算法的性能理论上是比 Boyer-Moore-Horspool 算法还要好一点的,不过 Boyer-Moore 算法实作起来复杂很多,需要进行计算的地方很多,实际运行起来其性能也不一定总是比 Boyer-Moore-Horspool 算法好。
虽然 Boyer-Moore-Horspool 算法不是本篇文章的重点,不过笔者在此还是放一下 Boyer-Moore-Horspool 算法的程序实作。
Quick Search Algorithm
Quick Search Algorithm 与 Boyer-Moore-Horspool 十分相像,差别只在于 Quick Search Algorithm 对于坏字符的选择策略是,在样本匹配失败时「永远把正在匹配的原文范围的下一个字符当作是坏字符」。
重新使用以上的例子,来演示处理过程:
HERE IS A SIMPLE EXAMPLE
EXAMPLE

HERE IS A SIMPLE EXAMPLE
        EXAMPLE

HERE IS A SIMPLE EXAMPLE
         EXAMPLE

HERE IS A SIMPLE EXAMPLE
                 EXAMPLE
在这个例子中,Quick Search Algorithm 比 Boyer-Moore-Horspool 算法和 Boyer-Moore 算法都还要快。
同样地,再拿刚刚移动索引值的例子来比较:
RPOIXYZABCDAEEFGHIJKLM
       ABCDEEE
使用 Boyer-Moore 算法的话,样本经过位移之后会变成:
RPOIXYZABCDAEEFGHIJKLM
           ABCDEEE
移动了四个索引值。
使用 Boyer-Moore-Horspool 算法的话,样本经过位移之后会变成:
RPOIXYZABCDAEEFGHIJKLM
        ABCDEEE
只移动了一个索引值。
而使用 Quick Search Algorithm 的话,样本经过位移之后会变成:
RPOIXYZABCDAEEFGHIJKLM
               ABCDEEE
移动了八个索引值!
所以 Quick Search Algorithm 一定是最快的吗?很可惜,若是以下的例子,就会是 Boyer-Moore-Horspool 算法比较快。
RPOIXYZABCDAEEFGHIJKLM
       ABCDDFG
使用 Boyer-Moore-Horspool 算法的话,样本经过位移之后会变成:
RPOIXYZABCDAEEFGHIJKLM
              ABCDDFG
移动了七个索引值!
而使用 Quick Search Algorithm 的话,样本经过位移之后会变成:
RPOIXYZABCDAEEFGHIJKLM
         ABCDDFG
只移动了两个索引值。
也就是说,Quick Search Algorithm 和 Boyer-Moore-Horspool 算法的搜索速度是互有输赢。
虽然 Quick Search Algorithm 也不是本篇文章的重点,不过笔者在此还是放一下 Quick Search Algorithm 的程序实作。
Boyer-Moore-MagicLen
Boyer-Moore-MagicLen 的概念
Boyer-Moore-MagicLen 算法是笔者结合 Boyer-Moore-Horspool 和 Quick Search Algorithm 的特色所想出的算法,在样本匹配失败时,会「永远把正在匹配的原文范围的最后一个字符和下一个字符当作是坏字符」,所以可以求得两个坏字符位移,再仿效 Boyer-Moore 算法选择坏字符位移和好后缀位移之最大值的方式,Boyer-Moore-MagicLen 算法也会选择使用这两个坏字符位移的最大值。如此一来可以实现出不比 Boyer-Moore-Horspool 算法或 Quick Search Algorithm 还要慢的算法。
Boyer-Moore-MagicLen 的过程
直接举个例子来逐步说明 Boyer-Moore-MagicLen 算法:
HERE IS A SIMPLE EXAMPLE, WHICH CONTAINS MULTIPLE EXAMPLES. SIXLEE IS A WRONG WORD. EXAMPLEEXAMPLE
现在要搜索以上这段文字内所有的 EXAMPLE 字符串。
一开始的时候,要搜索的样本的第一个字符会对齐于原文中索引 0 的位置。
HERE IS A SIMPLE EXAMPLE, WHICH CONTAINS MULTIPLE EXAMPLES. SIXLEE IS A WRONG WORD. EXAMPLEEXAMPLE
EXAMPLE
接着从样本尾端开始往前判断该位置的字符是否与原文中对应位置的字符相符合。在这里样本 EXAMPLE 的尾端 E,所对应的原文字符是 S,并不相同,所以样本无法匹配成功,此时会得到两个坏字符,一个是正在匹配的原文范围的最后一个字符 S,另一个是其下一个字符 (空格)。
坏字符位移的目的是要把 EXAMPLE 这个样本往右移动最少几个索引值后,样本本身所含有的坏字符能和刚刚在原文中发现的坏字符对齐。如果样本右移之后并没有办法对齐「坏字符」,位移目的则会改为把 EXAMPLE 这个样本往右移动最少几个索引值后,样本的第 1 个字符会在原文的「坏字符」的下一个索引位置。
因此,若坏字符是 S,则须使样本向右位移 7 个索引值;若坏字符是 (空格),则须使样本向右位移 8 个索引值。在挑选最大坏字符位移值的原则下,我们会选择将样本向右位移 8 个索引值。
HERE IS A SIMPLE EXAMPLE, WHICH CONTAINS MULTIPLE EXAMPLES. SIXLEE IS A WRONG WORD. EXAMPLEEXAMPLE
        EXAMPLE
接着一样,在这里样本 EXAMPLE 的尾端 E,所对应的原文字符是 L,并不相同,所以样本无法匹配成功,此时会得到两个坏字符,一个是正在匹配的原文范围的最后一个字符 L,另一个是其下一个字符 E。
因此,若坏字符是 L,则须使样本向右位移 1 个索引值;若坏字符是 E,则须使样本向右位移 1 个索引值。所以样本向右位移 1 个索引值。
HERE IS A SIMPLE EXAMPLE, WHICH CONTAINS MULTIPLE EXAMPLES. SIXLEE IS A WRONG WORD. EXAMPLEEXAMPLE
         EXAMPLE
在这里样本尾端的 MPLE 有匹配成功,但是 A 和其所对应的原文字符是 I,并不相同,所以样本无法匹配成功,此时会得到两个坏字符,一个是正在匹配的原文范围的最后一个字符 E,另一个是其下一个字符 (空格)。
因此,若坏字符是 E,则须使样本向右位移 6 个索引值;若坏字符是 (空格),则须使样本向右位移 8 个索引值。在挑选最大坏字符位移值的原则下,我们会选择将样本向右位移 8 个索引值。
HERE IS A SIMPLE EXAMPLE, WHICH CONTAINS MULTIPLE EXAMPLES. SIXLEE IS A WRONG WORD. EXAMPLEEXAMPLE
                 EXAMPLE
重做上面的步骤从样本尾端开始检查字符,发现这个位置正好符合我们要找的样本。那如果要继续搜索下去的话该怎么做呢?在这时候可以把正在匹配的原文范围的下一个字符当作是坏字符,也就是 ,。
若坏字符是 ,,则须使样本向右位移 8 个索引值。
HERE IS A SIMPLE EXAMPLE, WHICH CONTAINS MULTIPLE EXAMPLES. SIXLEE IS A WRONG WORD. EXAMPLEEXAMPLE
                         EXAMPLE
接下来的步骤就都和上述的一样了。完整过程如下:
HERE IS A SIMPLE EXAMPLE, WHICH CONTAINS MULTIPLE EXAMPLES. SIXLEE IS A WRONG WORD. EXAMPLEEXAMPLE
EXAMPLE

HERE IS A SIMPLE EXAMPLE, WHICH CONTAINS MULTIPLE EXAMPLES. SIXLEE IS A WRONG WORD. EXAMPLEEXAMPLE
        EXAMPLE

HERE IS A SIMPLE EXAMPLE, WHICH CONTAINS MULTIPLE EXAMPLES. SIXLEE IS A WRONG WORD. EXAMPLEEXAMPLE
         EXAMPLE

HERE IS A SIMPLE EXAMPLE, WHICH CONTAINS MULTIPLE EXAMPLES. SIXLEE IS A WRONG WORD. EXAMPLEEXAMPLE
                 EXAMPLE

HERE IS A SIMPLE EXAMPLE, WHICH CONTAINS MULTIPLE EXAMPLES. SIXLEE IS A WRONG WORD. EXAMPLEEXAMPLE
                         EXAMPLE

HERE IS A SIMPLE EXAMPLE, WHICH CONTAINS MULTIPLE EXAMPLES. SIXLEE IS A WRONG WORD. EXAMPLEEXAMPLE
                                 EXAMPLE

HERE IS A SIMPLE EXAMPLE, WHICH CONTAINS MULTIPLE EXAMPLES. SIXLEE IS A WRONG WORD. EXAMPLEEXAMPLE
                                         EXAMPLE

HERE IS A SIMPLE EXAMPLE, WHICH CONTAINS MULTIPLE EXAMPLES. SIXLEE IS A WRONG WORD. EXAMPLEEXAMPLE
                                          EXAMPLE

HERE IS A SIMPLE EXAMPLE, WHICH CONTAINS MULTIPLE EXAMPLES. SIXLEE IS A WRONG WORD. EXAMPLEEXAMPLE
                                                  EXAMPLE

HERE IS A SIMPLE EXAMPLE, WHICH CONTAINS MULTIPLE EXAMPLES. SIXLEE IS A WRONG WORD. EXAMPLEEXAMPLE
                                                          EXAMPLE

HERE IS A SIMPLE EXAMPLE, WHICH CONTAINS MULTIPLE EXAMPLES. SIXLEE IS A WRONG WORD. EXAMPLEEXAMPLE
                                                                EXAMPLE

HERE IS A SIMPLE EXAMPLE, WHICH CONTAINS MULTIPLE EXAMPLES. SIXLEE IS A WRONG WORD. EXAMPLEEXAMPLE
                                                                        EXAMPLE

HERE IS A SIMPLE EXAMPLE, WHICH CONTAINS MULTIPLE EXAMPLES. SIXLEE IS A WRONG WORD. EXAMPLEEXAMPLE
                                                                                EXAMPLE

HERE IS A SIMPLE EXAMPLE, WHICH CONTAINS MULTIPLE EXAMPLES. SIXLEE IS A WRONG WORD. EXAMPLEEXAMPLE
                                                                                    EXAMPLE

HERE IS A SIMPLE EXAMPLE, WHICH CONTAINS MULTIPLE EXAMPLES. SIXLEE IS A WRONG WORD. EXAMPLEEXAMPLE
                                                                                          EXAMPLE

HERE IS A SIMPLE EXAMPLE, WHICH CONTAINS MULTIPLE EXAMPLES. SIXLEE IS A WRONG WORD. EXAMPLEEXAMPLE
                                                                                           EXAMPLE
如此一来,找到最后,可以知道 EXAMPLE 字符串开始于文字中索引值为 17, 50, 84, 91 的位置。

若要做反向搜索,过程如下:
HERE IS A SIMPLE EXAMPLE, WHICH CONTAINS MULTIPLE EXAMPLES. SIXLEE IS A WRONG WORD. EXAMPLEEXAMPLE
                                                                                           EXAMPLE

HERE IS A SIMPLE EXAMPLE, WHICH CONTAINS MULTIPLE EXAMPLES. SIXLEE IS A WRONG WORD. EXAMPLEEXAMPLE
                                                                                     EXAMPLE

HERE IS A SIMPLE EXAMPLE, WHICH CONTAINS MULTIPLE EXAMPLES. SIXLEE IS A WRONG WORD. EXAMPLEEXAMPLE
                                                                                    EXAMPLE

HERE IS A SIMPLE EXAMPLE, WHICH CONTAINS MULTIPLE EXAMPLES. SIXLEE IS A WRONG WORD. EXAMPLEEXAMPLE
                                                                            EXAMPLE

HERE IS A SIMPLE EXAMPLE, WHICH CONTAINS MULTIPLE EXAMPLES. SIXLEE IS A WRONG WORD. EXAMPLEEXAMPLE
                                                                    EXAMPLE

HERE IS A SIMPLE EXAMPLE, WHICH CONTAINS MULTIPLE EXAMPLES. SIXLEE IS A WRONG WORD. EXAMPLEEXAMPLE
                                                            EXAMPLE

HERE IS A SIMPLE EXAMPLE, WHICH CONTAINS MULTIPLE EXAMPLES. SIXLEE IS A WRONG WORD. EXAMPLEEXAMPLE
                                                    EXAMPLE

HERE IS A SIMPLE EXAMPLE, WHICH CONTAINS MULTIPLE EXAMPLES. SIXLEE IS A WRONG WORD. EXAMPLEEXAMPLE
                                                  EXAMPLE

HERE IS A SIMPLE EXAMPLE, WHICH CONTAINS MULTIPLE EXAMPLES. SIXLEE IS A WRONG WORD. EXAMPLEEXAMPLE
                                          EXAMPLE

HERE IS A SIMPLE EXAMPLE, WHICH CONTAINS MULTIPLE EXAMPLES. SIXLEE IS A WRONG WORD. EXAMPLEEXAMPLE
                                   EXAMPLE

HERE IS A SIMPLE EXAMPLE, WHICH CONTAINS MULTIPLE EXAMPLES. SIXLEE IS A WRONG WORD. EXAMPLEEXAMPLE
                           EXAMPLE

HERE IS A SIMPLE EXAMPLE, WHICH CONTAINS MULTIPLE EXAMPLES. SIXLEE IS A WRONG WORD. EXAMPLEEXAMPLE
                   EXAMPLE

HERE IS A SIMPLE EXAMPLE, WHICH CONTAINS MULTIPLE EXAMPLES. SIXLEE IS A WRONG WORD. EXAMPLEEXAMPLE
                 EXAMPLE

HERE IS A SIMPLE EXAMPLE, WHICH CONTAINS MULTIPLE EXAMPLES. SIXLEE IS A WRONG WORD. EXAMPLEEXAMPLE
         EXAMPLE

HERE IS A SIMPLE EXAMPLE, WHICH CONTAINS MULTIPLE EXAMPLES. SIXLEE IS A WRONG WORD. EXAMPLEEXAMPLE
  EXAMPLE
如此一来,找到最后,可以知道 EXAMPLE 字符串开始于文字中索引值为 91, 84, 50, 17 的位置。

Boyer-Moore-MagicLen 的坏字符位移表
了解 Boyer-Moore-MagicLen 的运作原理后,接着来谈谈怎么样才能快速进行「坏字符位移」。其实不论是 Boyer-Moore-Horspool 算法还是 Quick Search Algorithm,坏字符位移的计算方式都是先产生一个集合来保存样本的字符从尾端开始往前看的出现顺序。
比如说,样本 EXAMPLE 的 P,它就是从尾端开始算起的第 3 个字符,而 M 则是从尾端开始算起的第 4 个字符。因此若要把 P 或 M 移动到目前样本尾端 E 的位置,则需要分别将样本往右位移 2 或 3 个索引值。这个计算方式得利于 Boyer-Moore-Horspool 算法和 Quick Search Algorithm 永远都是选择目前判断的原文范围的最后一个字符或其下一个字符作为坏字符的作法,如果是像 Boyer-Moore 算法那样是选择好后缀之前的字符作为坏字符的话,那么计算坏字符位移的方式就会变得复杂很多,更不用说计算好后缀位移的复杂程度了。
所以样本 EXAMPLE 经过上述的方式,所创建出来的「坏字符位移表」如下:
T['L'] = 1;
T['P'] = 2;
T['M'] = 3;
T['A'] = 4;
T['X'] = 5;
T[others] = 7;
然而这边似乎出现了一个很奇怪的情形,T['E'] = 0 不就表示不移动吗?
如以下这个例子:
ABCDEFEXAMPLE
EXAMPLE
坏字符为 E 时,接下来该样本该如何位移?根本不能动对吧?也就是说这个坏字符位移表是会有问题的,我们并不能把样本最尾端的字符也算进去,所以正确的「坏字符位移表」应如下:
T['P'] = 2;
T['M'] = 3;
T['A'] = 4;
T['X'] = 5;
T['E'] = 6;
T[others] = 7;
如此一来就知道要把样本往右位移 6 个索引值。
ABCDEFEXAMPLE
      EXAMPLE
但如果坏字符并不是正在匹配的原文范围的最后一个字符,而是其下一个字符呢?难道把原先的「坏字符位移表」都加一就好了吗?像是这样:
T['P'] = 3;
T['M'] = 4;
T['A'] = 5;
T['X'] = 6;
T['E'] = 7;
T[others] = 8;
看似可行,但如果是遇到以下例子,要怎么让样本位移呢?
AEXAMPLEABCDEFG
EXAMPLE
坏字符为 E 时,如果直接查找「坏字符位移表」,会得到位移 7 的结果。
AEXAMPLEABCDEFG
       EXAMPLE
这样的位移肯定是有问题的,因为原文中索引 1 开始就有出现 EXAMPLE 子字符串,而它却被跳过了!
为了解决这个问题,我们可以有两种解决方法,第一种是直接修改选择使用正在匹配的原文范围的下一个字符作为坏字符时的「坏字符位移表」,除了把原本的「坏字符位移表」的位移值都加 1 之外,还要把样本最尾端的字符位移量改为 1,只不过这样在运算时就会需要两个「坏字符位移表」。如果要沿用「坏字符位移表」的话,可以在计算时,先去判断正在匹配的原文范围的下一个字符是否就是样本尾端字符,如果是的话就直接使用位移值 1,如果不是的话就再进行查表并将结果加 1。后者会是笔者比较建议的方式。
Boyer-Moore-MagicLen 算法的程序实作
如果要搜索的数据可能的值的数量范围并不大,例如只有 ISO-8859-1 编码的字符值范围,则可以直接使用长度为 256 的整数数组来制作「坏字符位移表」,性能会比使用 HashMap 还要好。不仅如此,事实上,所有支持自我同步(self-synchronizing)的字符串编码(如 UTF-8)都能使用长度为 256 的整数数组的「坏字符位移表」来正确运行 Boyer-Moore 相关的算法。
Boyer-Moore-MagicLen 算法的复杂度
这边计算的复杂度是以成功搜索到一个样本位置之后就结束算法为基准。
以 #{{n}}# 来表示要搜索的数据笔数。以 #{{m}}# 来表示要搜索的样本数据笔数。以 #{{k}}# 来表示要搜索的数据可能的值的数量。
| 项目 | 复杂度 | 备注 |
|---|---|---|
| 最差时间复杂度 | #{{O(m + k) + O(nm)}}# | 坏字符位移量都是 1。 |
| 最佳时间复杂度 | #{{O(m + k) + O({n \over m})}}# | 坏字符位移量都是 m 或 m + 1。 |
| 平均时间复杂度 | #{{O(m + k) + \Omega({n \over m})}}# | 平均时间复杂度不容易估计。 |
| 最差空间复杂度 | #{{O(m + k)}}# |